多个Agent能并行干活,不等于流程就可靠。最实用的做法是:让代码固定步骤、数据格式和审批点,只把需要理解与判断的局部交给Agent。读完你会知道“确定性骨架+概率性节点”怎样落到一个最小流程。
最新事件:Copilot把编排写进代码
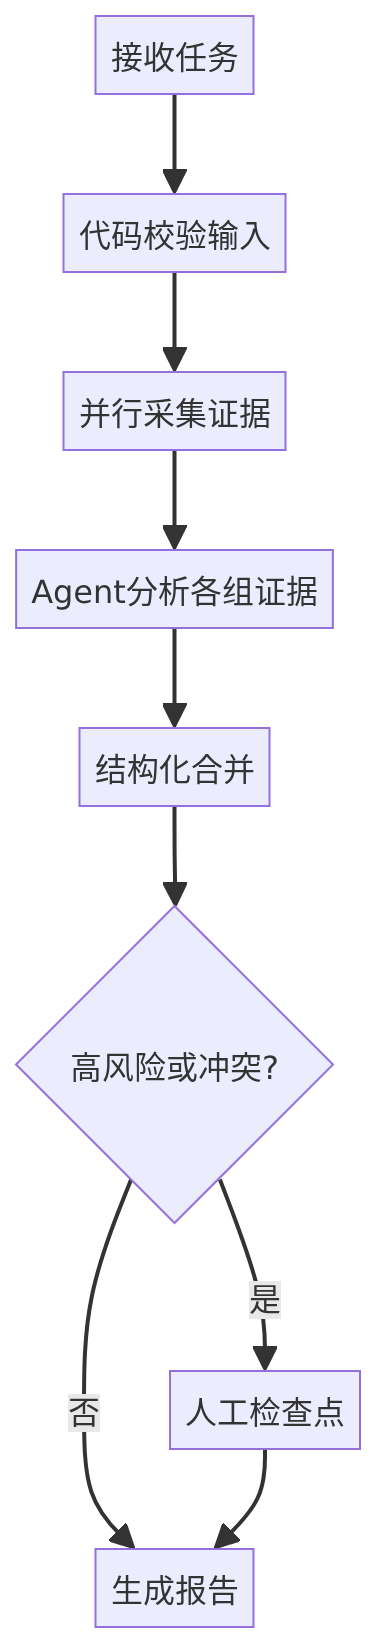
GitHub在2026年10月1日宣布,动态工作流进入Copilot CLI、Copilot应用和SDK,当前处于公共预览。官方定义很关键:工作流是一段规定任务如何执行的程序,自动步骤可以串行或并行,Agent只在指定位置参与。它能传递结构化结果、让子Agent交叉验证,也能在检查点暂停等待人工继续。
这与“给一个目标,让Agent自己规划”不是同一种产品选择。前者牺牲一点自由,换来重复执行、可观测和费用边界。
这个概念解决的不只是“Agent会不会乱跑”。在生产环境里,团队还要回答:为什么这次启动了三个子任务,哪个输出被采用,当模型或工具升级后是否仍执行同样的检查,以及谁批准了有副作用的步骤。把流程写成程序,才能对这些问题做版本对比和自动测试。
生活类比:厨房里的菜谱与厨师
工作流像菜谱:先备料、再加热、最后装盘,过敏原检查不能跳过;Agent像厨师,可以根据食材状态判断火候。类比的边界是,软件流程会面对超时、重试、外部副作用和非确定输出,所以还需要唯一任务标识、结构化契约与可恢复状态。
去掉类比后的准确定义
确定性编排,是用代码显式规定节点、依赖、并发、输入输出契约和失败处理。Agent节点仍可以生成不同内容,但它不能擅自删除审批、改变并行数或把“分析结果”当成“已执行操作”。核心不是把每个推理写死,而是把不能由模型猜的规则写死。
设计时可以把节点分为三类。第一类是确定性工具,例如读取日志、运行测试和校验JSON,相同输入应有相同语义。第二类是概率性判断,例如归纳根因候选,必须限定输出结构。第三类是副作用,例如发布、写库或发消息,需要幂等键和审批。分类之后,每类的重试、超时和回收策略才有可能写清。
最小实践:事故分析的确定性骨架
依赖安装:无。保存为workflow.py,运行python3 workflow.py。真实项目里,analyze可替换为返回固定JSON字段的模型调用。
from concurrent.futures import ThreadPoolExecutor

def collect(name):
    rates = {"api": 0.12, "db": 0.01}
    return {"service": name, "error_rate": rates[name]}

def analyze(item):
    return {**item, "suspect": item["error_rate"] > 0.05}

services = ["api", "db"]
with ThreadPoolExecutor() as pool:
    evidence = list(pool.map(collect, services))

findings = [analyze(item) for item in evidence]
report = {
    "suspects": [x["service"] for x in findings if x["suspect"]],
    "approved": False,  # 必须由人改为True
}

print(report)
assert report == {"suspects": ["api"], "approved": False}
代码先由程序固定采集对象和并发方式,再产生结构化findings,最后把approved默认为假。本文示例已于本次任务中使用Python 3.9.6实际运行,断言通过。它验证的是边界设计,未运行GitHub Copilot动态工作流本体。
常见误区
第一,把“用代码编排”理解为不再需要Agent。事实上,代码管流程,Agent处理非结构化证据。第二,认为并行越多越快;工具限额、共享文件和下游模型都可能成为瓶颈。第三,只要两个Agent同意就当成真;它们可能共享同一错误来源,交叉验证还要求证据独立。第四,以为暂停点自然可恢复;没有持久化输入、版本和中间结果,恢复可能重复产生副作用。
还有一个容易被忽略的误区:把“有日志”等同于“可观测”。真正可观测的工作流至少要能按任务ID还原节点输入摘要、输出版本、耗时、错误类型、费用和审批人,同时不把密钥与隐私文本原样记入日志。否则问题发生时,团队仍只能靠猜。
适用与不适用
它适合发布检查、批量PR审查、事故研判和可能运行很久的调查。单次简单改文案、一次性查询,或本来就没有多阶段约束的任务,普通对话更直接。涉及付款、删除、发布和对外发送时,即使有动态工作流,也应保留服务端权限检查与明确确认。
判断是否值得编排的一个简单准则是:该任务是否会重复,失败是否有明确代价,以及事后是否必须解释。三者中有两项为真,就值得把关键步骤从自由对话提升为代码化流程。
我的判断
多Agent产品的分水岭,不是能同时启动多少模型,而是能否把“每次都必须一样的部分”从提示词里拿出来,变成可测试的代码。GitHub这次更新值得关注,正因为它承认Agent的自由应当被工作流包围,而不是反过来。先用一个高频、失败代价明确的流程试点,比把所有对话一次性改造更稳妥。
5分钟实践题
为示例加入cache服务,让它的错误率为8%;再加一条确定规则:嫌疑服务超过一个时,必须保持approved=False并输出needs_review=True。想一想:如果analyze由模型实现,你要校验哪些字段才能防止它跳过审批?
你的Agent流程中,哪一步最需要从自由对话改成代码化检查点?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。