
编者按|我的判断:Barclays 这类公告最容易被读成「AI 要替代程序员」,但真正的变化在别处——当代码生成的边际成本降下来,「证明这次变更可以上线」反而成了新的稀缺能力。对 Java 工程师来说这不是坏消息:你熟悉的老系统历史包袱、批处理时窗、监管留痕,恰恰是模型补不上的部分。下面把这条判断拆成能立刻动手的动作。
一家大型银行计划让半数开发人员在年底前用上Claude Code,这是强烈的采用信号,但还不是“生产力提高了多少”的证据。对开发者更有价值的判断是:当代码生成更便宜,需求澄清、测试设计、系统边界和可审计证据会变得更稀缺。
公告中真正可核验的数字
Anthropic在2026年10月1日宣布与Barclays扩大合作。按官方披露,Barclays预计Claude Code在2026年底覆盖50%的开发人员,2027年扩大到大多数软件工程师。该行的Colleague Knowledge Assistant自2025年起运行,采用检索增强生成(RAG)架构,已有超过16000名员工使用,处理超过100万次搜索,面向超过2000万英国零售客户的服务。
在全球市场业务中,Claude模型用于对客户来信分类、丰富信息并选择处理路由,官方称平台每天处理约12万封邮件。这些数字证明部署规模与工作流覆盖,不自动证明准确率、漏报率、客户等待时间或软件缺陷率已改善。这是阅读厂商合作公告时必须守住的边界。
另一个容易误读的数字是“100万次搜索”。它说明员工确实在使用,却不告诉我们每次答案是否找到正确制度、是否引用当前版本,或员工最终是否仍需要人工搜索。真正的RAG评估至少应分开检索召回、答案忠实度、文档新鲜度、权限泄漏与员工改判率。只有搜索量,无法分辨“很好用”和“不得不反复问”。
从“写代码”到“证明变更可以上线”
银行的遗留系统不是单个旧编程语言问题。它通常同时携带历史业务规则、批处理时窗、下游报表契约、监管留痕和稀缺的隐性知识。AI可以加快代码阅读、测试初稿和重构候选,却不知道某个看似多余的分支是否对应一条监管义务。
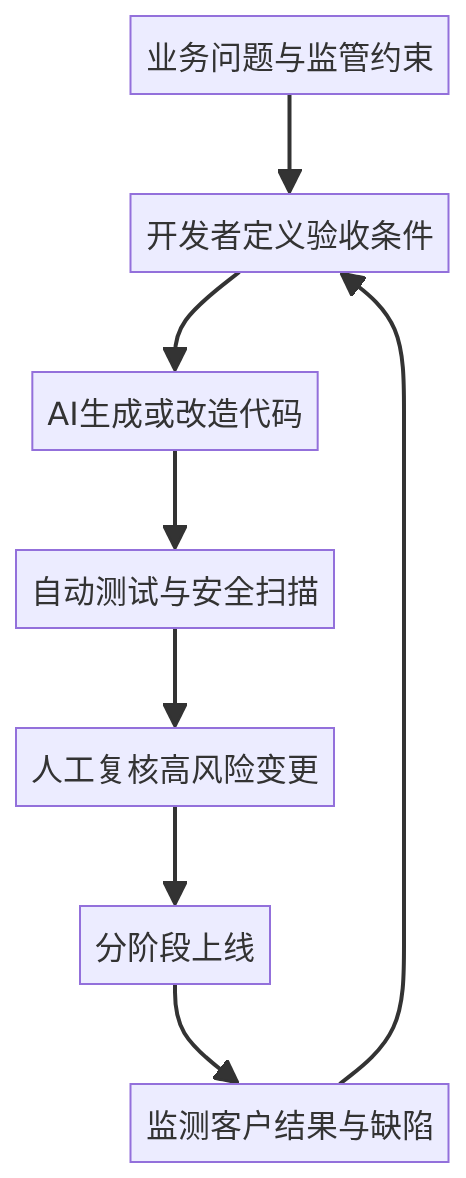
因此,工程岗位会从代码产出向责任链重心转移:能否把含糊需求改成可验收条件,能否构造金额边界、幂等重试、权限分离和数据回放测试,能否解释模型生成的迁移计划为什么不破坏日终批处理。这些都不是“提示词写得更像命令”可以取代的能力。
代码审查的工作也会改变。审查者不能只问语法是否正确,而要核对生成代码所依赖的需求版本、数据范围、失败语义与监控信号。AI很擅长补全局部模式,也容易把一个在新服务里常见的做法套到不允许相同失败方式的老系统。熟悉历史事故和业务不变式的人,会比单纯写得快的人更有价值。
落到 Java 工程师手上:这周就能做的三件事
上面的判断如果只停在认知层,对日常开发没有意义。结合受监管系统常见的写法,有三件事这周就能落地:
1. 给「需求版本」打标,让生成代码可追溯
在 PR 模板里强制加一行「需求文档版本 / 来源链接」。模型生成的代码必须绑定具体需求版本,没有版本的需求不进 review。这条最土,但它决定了半年后你能不能回答「这段代码当初为什么这么写」。
2. 把「可上线证据」写进 CI,而不是写进文档
金额边界、幂等重试、权限分离这三类用例必须存在,缺任何一类 CI 直接红。受监管系统的历史事故,绝大多数不是语法错,而是这三类边界没被验证。
3. 老系统里「看不出用途的分支」,先问再删
模型看到一个 if 分支没被单测覆盖,第一反应是删掉;但那个分支可能对应一条监管义务或一次历史事故的补丁。处理顺序应当是:git blame → 事故记录 → 再决定。
Code Review 检查清单(可直接贴到团队规范)
| 检查项 | 为什么 | 不合格怎么办 |
|---|---|---|
| 需求版本是否标注 | 决定半年后能否追溯变更原因 | 打回补版本,不进 review |
| 金额/边界用例是否存在 | 受监管系统事故高发区 | CI 红,禁止合并 |
| 幂等与重试语义 | 重复请求可能造成真实资金损失 | 要求补充幂等键设计 |
| 删除的分支是否有出处 | 可能是监管义务或事故补丁 | 查 git blame 后再放行 |
| 是否引入新的数据出域 | 客户来信/交易数据常见泄漏点 | 安全组复核 |
一个最小可复现的验证:给 AI 变更单独打标
想知道 AI 生成的代码到底有没有提效,唯一可信的指标是人工改判率——它比「生成了多少行」诚实得多。在 Spring Boot 里用一个切面就能开始采集:
@Aspect
@Component
public class AiChangeAudit {

    private static final Logger log = LoggerFactory.getLogger(AiChangeAudit.class);

    /** 给 AI 生成的变更单独打标:记录耗时、成败,供后续统计人工改判率 */
    @Around("@annotation(AiGenerated)")
    public Object audit(ProceedingJoinPoint pjp) throws Throwable {
        long t0 = System.nanoTime();
        String sig = pjp.getSignature().toShortString();
        try {
            Object ret = pjp.proceed();
            log.info("[ai-change] signature={} status=OK costMs={}",
                     sig, (System.nanoTime() - t0) / 1_000_000);
            return ret;
        } catch (Throwable e) {
            log.info("[ai-change] signature={} status=FAIL ex={}",
                     sig, e.getClass().getSimpleName());
            throw e;
        }
    }
}
跑两周后,按 signature 聚合出「哪些位置的 AI 变更最常被人工改回」,这份清单就是你团队真正该收敛的地方。没有数据之前,关于 AI 提效的讨论都是立场之争。
具体场景:邮件路由不能只看平均准确率
假设每天12万封邮件里,99%是普通查询,1%是时效严格的交易指令。一个模型只要把普通查询处理得很好,整体准确率就可以很高;但少量关键邮件的漏报仍可能造成重大损失。工程团队要分类看召回率、错误路由、人工改判和最坏处理延迟,还要对高风险类别设置失败关闭,不能被一个宏观数字说服。
对开发者和管理者的行动建议
开发者现在可以主动练四件事。第一,把业务规则变成可执行测试,尤其是金额、日期、幂等和权限边界。第二,为AI产出保留来源、审批人、测试证据与回滚路径。第三,学会按风险分类评估,别只上报平均工时或生成行数。第四,把遗留知识写成文档、架构决策记录和运行手册,否则AI只会更快地猜。
管理者则应把采用率与效果指标分开:多少人用AI,是推广指标;从需求到生产的周期、逃逸缺陷、安全事件、回滚率和客户等待时间,才是工程与业务结果。
更可行的度量设计是分阶段做对照。先在同类任务中比较交付周期、评审往返次数和测试失败,再追踪上线后的缺陷与回滚,同时记录模型、工具、任务类型和开发者经验。如果只看“用了AI的PR数”,团队很可能奖励使用量,而不是更安全、更有价值的软件。
我的判断与风险
Barclays案例说明,AI已从个人试用进入受监管机构的系统性部署。但职业结论不应是“工程师将被替代”或“人只负责创意”。更准确的说法是,代码初稿的稀缺性下降,而能对真实系统后果负责的人更重要。由于该文来自Anthropic与客户的合作公告,成本、准确率、缺陷率、安全事件和经对照的生产力收益都需等待独立数据。
本文初稿未提供代码,因为核心是职业与治理判断;这里补充一段最小切面代码,是为了让「AI 变更到底有没有提效」可以用数据回答,而不是停留在立场之争。
如果团队明年让半数开发者高频使用AI,你最想先补测试、文档、权限,还是效果指标?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
相关阅读
- AI权限写进JSON就安全了吗?真正缺的是配置生效验证 — 同样讲「配置不等于生效」
- 模型能正常出字,答案却悄悄变差:推理配置漂移比报错更危险 — 静默回归的监测思路
- Claude Sonnet 5.5迁移:用离线评测和灰度指标防止静默回归 — 灰度与离线评测落地
本文首发于 java4u.cn,转载请注明出处。