Hugging Face在9月30日发布Open TTS Leaderboard,给“哪个开源语音模型最好”降了降温:没有脱离场景的第一名。语音Agent在意多久能听到第一段声音,批量有声书在意吞吐,声音克隆还要检查身份相似度,而自然度最终仍需人听。
发生了什么
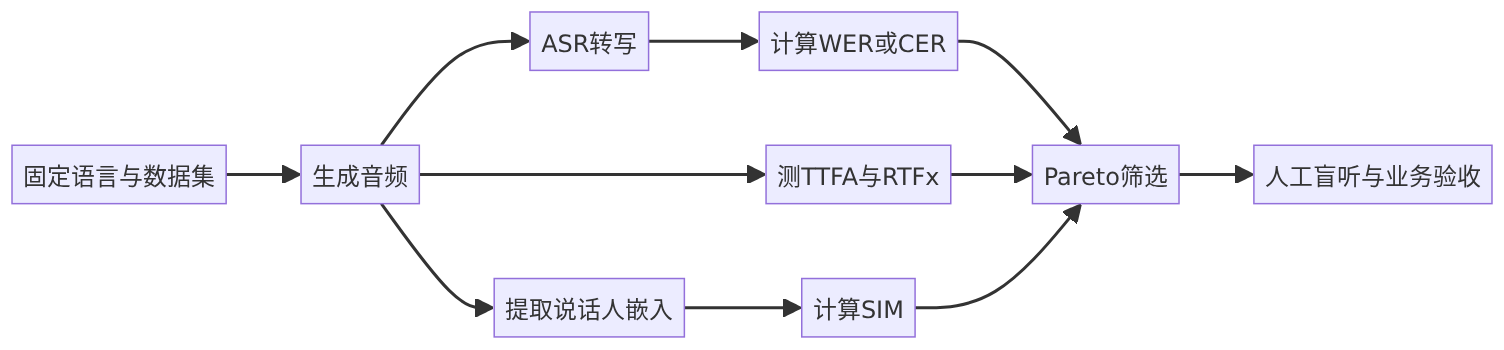
官方统计当时Hub上已有超过8000个文本转语音(Text-to-Speech,TTS)模型,但人工竞技场加入新模型慢、开放权重模型部署成本高。新榜单用可重复的客观指标先做规模化比较:用自动语音识别结果计算词错误率或字错误率,用逆实时因子衡量离线吞吐,用首段音频时间衡量流式交互延迟,再用WavLM说话人嵌入的余弦相似度评估克隆声音与参考音频的接近程度。
官方也主动划了边界:词错误率只是可懂度代理,相似度只是身份保持代理,两者都不直接衡量自然度、情绪表现或听众偏好。榜单计划开源评测脚本,但截至文章发布时仍写的是“很快”。
技术原理:多指标不能粗暴压成一个总分
如果把词错误率、首段延迟、模型大小和相似度直接加权,权重稍改,冠军就会换。更稳妥的第一步是找Pareto前沿:若模型A在所有指标上都不比B差,并且至少一项更好,B才被A支配。留下的模型没有“全面更差”的明显输家,再按真实业务设硬门槛。
最小实践:筛出没有被全面碾压的模型
下面用四项假数据演示。wer、ttfa_ms和size_gb越小越好,sim越大越好。依赖安装:无;保存为tts_pareto.py,运行python3 tts_pareto.py。
models = [
    {"name": "A", "wer": 4.8, "ttfa_ms": 310, "sim": 0.78, "size_gb": 2.2},
    {"name": "B", "wer": 5.1, "ttfa_ms": 180, "sim": 0.75, "size_gb": 0.8},
    {"name": "C", "wer": 6.3, "ttfa_ms": 420, "sim": 0.70, "size_gb": 2.8},
    {"name": "D", "wer": 4.9, "ttfa_ms": 260, "sim": 0.82, "size_gb": 3.1},
]

def dominates(a, b):
    no_worse = (
        a["wer"] <= b["wer"] and
        a["ttfa_ms"] <= b["ttfa_ms"] and
        a["sim"] >= b["sim"] and
        a["size_gb"] <= b["size_gb"]
    )
    strictly_better = any([
        a["wer"] < b["wer"], a["ttfa_ms"] < b["ttfa_ms"],
        a["sim"] > b["sim"], a["size_gb"] < b["size_gb"],
    ])
    return no_worse and strictly_better

frontier = [m for m in models
            if not any(dominates(other, m) for other in models if other != m)]

for model in frontier:
    print(model["name"])
assert [m["name"] for m in frontier] == ["A", "B", "D"]
模型C被A在四项上同时支配,因此先淘汰;A、B、D各有不可替代的优势。代码已在本次任务中使用Python 3.9实际运行,输出A、B、D并通过断言。它没有下载语音模型,也没有在H200或CPU上复现官方测量;数据是为讲清算法而造的,不是模型成绩。
一个具体场景
假设你做电话客服。业务要求首段音频小于250毫秒、中文字符错误率低于6%、模型能在单卡运行。先用硬门槛过滤,可能只剩B;然后再做带行业术语的中文盲听。如果是离线生成课程,首段延迟几乎无关,A或D可能凭可懂度与相似度胜出。同一榜单在不同产品里得到不同答案,才是正常结果。
四个指标分别会骗你什么
词错误率低,可能只是发音清楚,却不代表停顿自然;对中文还应看字符错误率,并单列数字、日期和中英混读。逆实时因子高,说明批量生成快,却不能回答用户多久能听到第一声。首段音频时间短,也可能靠极小分片换来频繁调度和播放卡顿,因此还要测后续分片间隔。说话人相似度高,只表示嵌入空间接近,不能证明情绪、年龄感或音色细节被忠实保留。
部署指标也不能缺席。模型大小不等于运行显存,量化、声码器、缓存与并发都会改变峰值;同一模型在H200、消费级GPU和CPU上的排序可能不同。实际验收最好把“模型加载后首请求”“预热后单请求”“稳定并发”和“长文本”拆开报告,避免把实验室吞吐当成交互体验。
如果产品支持流式打断,还要检查停止请求后模型是否继续占用算力,以及播放器缓冲区会不会把“已停止”的声音继续播完。这类交互指标不在单次TTFA里,却直接影响用户对语音Agent是否听话的判断。
我的判断及依据
这个榜单最大的贡献不是再排一次名,而是把TTS的“好”拆成可审查的维度。特别是把Time to First Audio(TTFA,首段音频时间)独立出来,对实时语音产品很关键。我的判断是,团队不该照抄榜单排序,而应复用它的评测协议:同硬件、同提示集、固定预热、报告中位数,并按语言分别看结果。
边界与风险
自动语音识别模型自身会偏向某些口音和语言;宏平均会让小语种与大语种同权,却不一定符合你的流量结构;说话人相似度高也可能伴随不自然韵律。声音克隆还涉及授权、冒用和水印治理。官方结果使用特定H200、CPU、默认声音和50条英文提示,不能直接代表你的并发、文本长度与中文领域词。
立即可执行的验收清单
固定语言、领域文本和硬件;至少记录P50与P95首段延迟;分开测冷启动和预热;对数字、专有名词、夹杂英文单列错误率;克隆场景加入授权和拒绝名单;最后进行随机化盲听,让听众分别评分自然度、情绪和可懂度。任何“总分第一”都要能还原到这些原始指标。
你的语音产品最不能妥协的是首包速度、可懂度、自然度还是声音相似度?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。