
很多训练流水线失败,不是代码错了,而是指定的GPU实例暂时没容量。AWS在9月15日为SageMaker训练与处理任务加入Instance Preferences:一次声明最多五种可接受实例,平台按顺序选择首个可用类型。这个功能看似只是少写重试脚本,背后却要求团队回答一个更重要的问题:哪些算力对这项任务真的可替代?
发生了什么
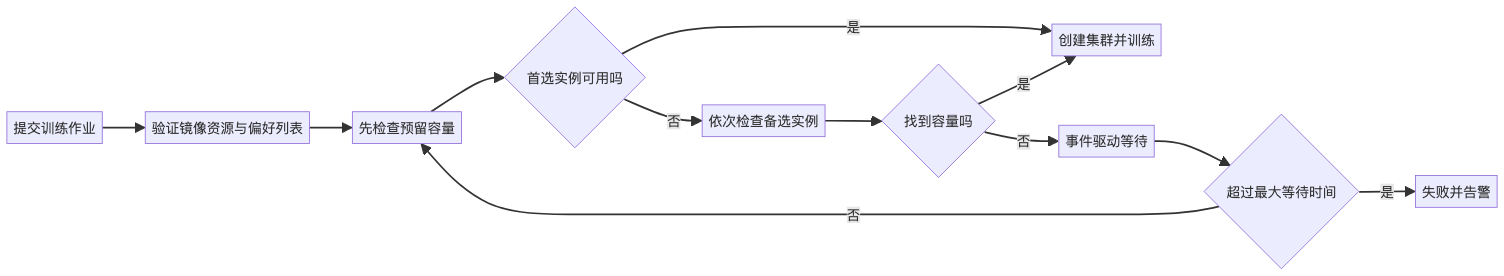
用户可在训练或处理作业中提交有序实例列表。SageMaker先验证配置,再以内存扫描的方式按优先级找容量;若全部暂不可用,作业进入事件驱动队列,在MaxPendingTimeInSeconds限制内自动重试。这个等待上限针对整张列表,而不是每一种实例分别计时,并且只在列表含加速计算实例时生效。
训练任务还能把预付费的Flexible Training Plan绑定到某个偏好项:先尝试已预留容量,再回退到按需实例。处理任务同样支持偏好列表,但官方明确说明它不支持Training Plan集成。
技术上真正改变了什么
以前常见做法是外部脚本轮询失败状态、取消作业、替换机型再提交。脚本必须处理重复提交、费用、日志关联和竞态,一旦异常退出,还可能留下孤儿资源。偏好列表把“选择哪种容量”交给调度平台,应用只声明顺序与等待上限,状态机更短。
但平台不会替你验证跨类型兼容性。官方特别提醒,SageMaker不会检查GPU架构、Elastic Fabric Adapter、驱动版本是否匹配。两种实例都能拉起容器,也不代表吞吐等价。比如两台H100节点与四台A100节点可能接近相同理论算力,但网络拓扑、显存和混合精度支持会改变实际步时。
一个具体场景
夜间微调必须在早晨数据刷新前完成。团队可以把已购买的P5计划放第一位,把按需P4d、P4de放后面,并设置30分钟最大等待。如果预留容量已占满,平台自动尝试备选;若全部不可用则明确失败,让编排系统选择跳过本轮,而不是脚本无限轮询。
这里的关键不是把所有GPU都塞进列表。训练镜像要对每项做启动测试;批量、梯度累积和节点数也要按显存与吞吐调整。否则“更快开始”可能换来训练更慢、费用更高,甚至数值结果变化。
团队还应把“容量回退”与“训练可恢复”配套设计。若首选集群运行数小时后中断,偏好列表只负责下一次找到机器,并不会自动保证检查点能跨架构恢复。优化器状态、随机数种子、分布式切分方式和存储带宽都可能成为新的失败点。因此,首次启用前应故意中断一次小任务,再从备选实例恢复并比较损失曲线。
我的判断与边界
我的判断是,云上GPU调度正在从“请求某个型号”转向“声明任务约束和偏好”。这能提升容量利用率,也迫使MLOps团队把隐含兼容性写成显式契约。真正成熟的任务应该能说明最低显存、允许的架构、最大排队时间、预算上限和预期吞吐,而不是只有一个机型字符串。
官方称功能可更快获得容量,但没有公布普遍等待时间下降多少;效果取决于区域、时间和备选集合。自动回退也不保证更便宜,按需实例可能高于预留成本。涉及确定性复现或硬件特定内核时,固定型号仍是合理选择。
还要警惕“首个有容量”被误解为“当前最优”。调度器遵循用户给定的优先顺序,不会综合预测总完成时间、跨区流量或电价。偏好顺序仍是团队的工程判断,最好依据近期真实数据定期更新,而不是一次配置后永久不动。
对需要严格复现实验的研究任务,可把固定硬件作为第一阶段,确认结论后再用偏好列表扩展吞吐;对时效优先的生产再训练,则可以接受更宽的备选范围。两类任务不要共用一套默认策略。
可立即执行的检查表
- 从历史作业筛出真正因容量不足失败的任务,不盲目改全部流水线。
- 为每种备选实例跑小规模镜像、驱动和分布式通信测试。
- 按等价吞吐调整节点数,而不是默认所有机型一比一替换。
- 设置最大等待时间、最大运行时间和成本告警。
- 在日志中记录最终选中的实例类型,便于比较步时、费用与结果。
- 预留容量优先,按需回退,并明确何时宁可失败也不超预算。
你的训练任务更怕排队半小时,还是换到备选GPU后成本与结果不可控?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。