NVIDIA在9月30日公布HSTU生成式推荐的端到端部署流程:PyTorch提前编译、FlexKV缓存、原生C++回放,再由Dynamo-Triton服务。最吸睛的是八层模型在批量8、GPU缓存100%命中时最高5.93倍的延迟改善,但真正决定你能否拿到收益的,是线上用户历史前缀有多稳定。
发生了什么
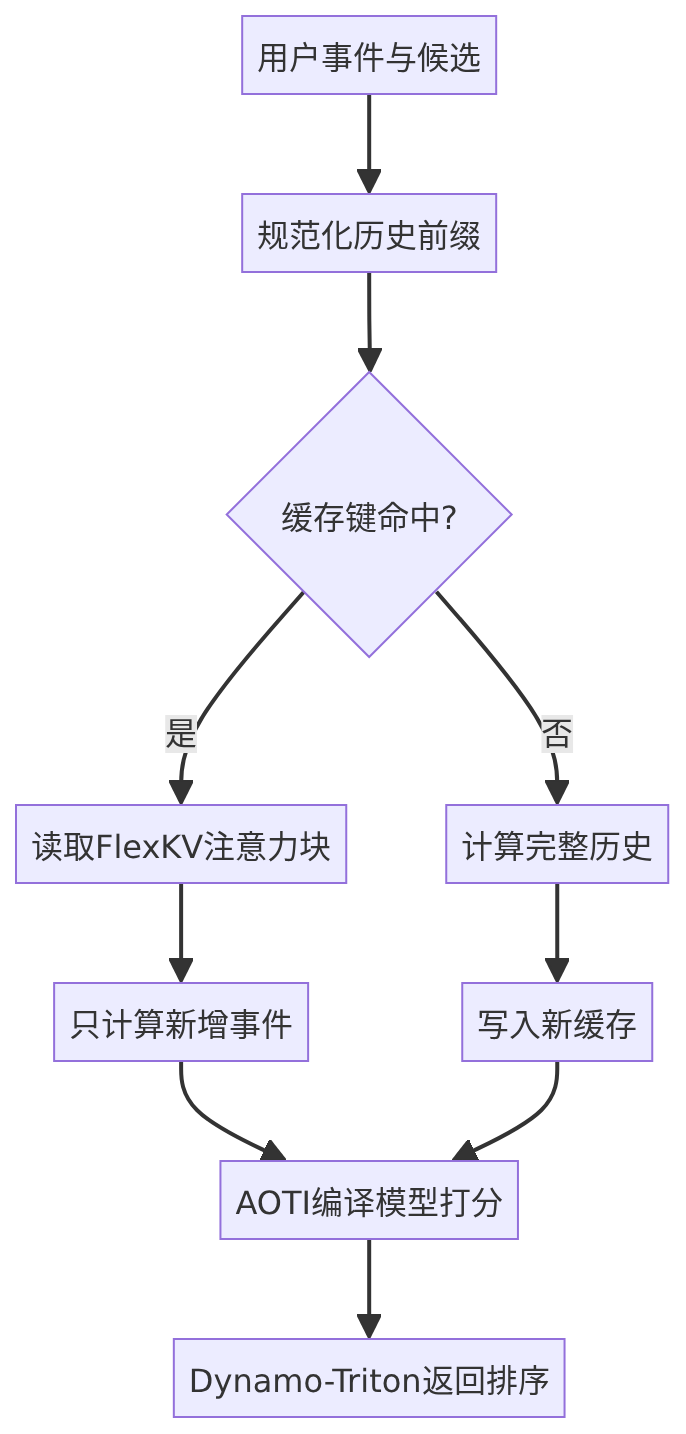
Hierarchical Sequential Transduction Unit(HSTU,分层序列转导单元)把推荐改写为序列建模:用户上下文、物品、动作和候选项成为高基数事件流中的Token。官方工作流用PyTorch Ahead-of-Time Inductor(AOTI,提前编译器)导出原生制品,用NV Embedding Cache保留热点嵌入,再用FlexKV复用不变历史的注意力状态。
基准在RTX PRO 6000 Blackwell Workstation Edition上进行。批量8且GPU KV缓存完全命中时,三层模型每逻辑请求0.423毫秒,八层0.678毫秒;相对同一AOTI配置但无缓存,官方报告最高4.47倍与5.93倍改善。这里的“最高”和“100%命中”必须与结果一起引用。
技术原理:推荐请求也有可复用前缀
用户每次刷新推荐,长历史往往大部分不变,只在尾部增加一两个行为。若缓存键正确绑定用户、模型版本、特征版本和历史边界,就能直接取回旧前缀的键值状态,只计算新增部分。AOTI减少Python运行开销,缓存减少重复注意力计算,两者解决的不是同一个瓶颈。
最小实践:先画命中率敏感性曲线
下面用官方八层模型的“最高5.93倍”构造理想上界,再加入每次缓存查询0.03毫秒的假设开销,估算不同命中率下的平均延迟。依赖安装:无;保存为cache_gate.py,运行python3 cache_gate.py。
BASE_MS = 0.678 * 5.93   # 由官方最高倍数反推的示意无缓存延迟
HIT_MS = 0.678
LOOKUP_MS = 0.03

def expected_latency(hit_rate: float) -> float:
    hit = HIT_MS + LOOKUP_MS
    miss = BASE_MS + LOOKUP_MS
    return hit_rate * hit + (1 - hit_rate) * miss

def speedup(hit_rate: float) -> float:
    return BASE_MS / expected_latency(hit_rate)

for rate in (0.0, 0.25, 0.5, 0.75, 1.0):
    print(f"hit={rate:.0%} latency={expected_latency(rate):.3f}ms "
          f"speedup={speedup(rate):.2f}x")

production_hit_rate = 0.50
assert speedup(production_hit_rate) < 2.0
assert speedup(1.0) > 5.0
代码把命中与未命中按线上比例加权,提醒你满命中加速不是平均收益。示例已在本次任务中使用Python 3.9实际运行:50%命中时估算不足2倍,100%命中时超过5倍,两条断言通过。输入中的查询开销是假设值;本次没有GPU、未下载HSTU权重、未构建AOTI制品,也未复现NVIDIA基准。
一个具体场景
短视频首页的活跃用户每隔几十秒刷新一次,历史前缀重复高,缓存可能有价值。匿名访客只有两三个行为,或隐私策略要求频繁轮换标识,缓存管理成本可能大于计算收益。若特征工程在后台修正旧事件,即使用户ID相同,旧KV也可能语义过期,不能当作命中。
一条更稳的验收顺序
第一步不是开缓存,而是固定一批可回放请求,比较PyTorch eager、AOTI和Dynamo-Triton在缓存关闭时的输出误差。第二步加入缓存,分别制造0%、25%、50%、75%和100%命中,记录端到端延迟而非只记模型内核。第三步修改用户历史中间位置,确认缓存键失效;再切换模型和特征版本,确认旧块不会被误用。第四步压满显存,观察淘汰是否让P99抖动或挤压嵌入缓存。
最后才看经济性。把缓存服务、额外显存、网络查询和运维成本折算到每千次请求,再与少用的GPU计算比较。若热点只占很小比例,可以只为长历史高频用户启用,而不是全量部署。这个分层策略往往比追求统一的高命中率更可控,也更容易回滚。
还应把推荐质量纳入同一张验收表。缓存前后不仅比较延迟,也比较候选集合、排序分数和线上关键指标;一旦版本切换后出现差异,应先判定是允许的数值误差、模型更新,还是读到了过期前缀。性能门禁与正确性门禁必须同时通过,不能用更快的P50掩盖少量用户的排序漂移。
我的判断及依据
这套方案真正成熟的信号不是单个加速数字,而是“同一导出制品被Python、原生C++与服务端回放验证”。推荐系统最怕离线模型和线上运行时含义漂移;复用同一制品与回放张量,能把正确性检查拉到部署链路里。性能优化应排在一致性之后,否则更快地返回错误排序没有意义。
适用边界与风险
收益依赖长序列、深模型、热点用户和稳定前缀。缓存会占GPU显存,并与嵌入表、批处理争资源;错误租户键可能造成数据越界;模型、词表或特征版本升级后必须失效旧缓存。官方基准排除了数据加载、服务启动、预热和休眠,不代表端到端页面延迟,也未给出所有命中率分布。
实践建议
上线前记录真实前缀复用率与缓存寿命;同时报告P50、P95、P99和淘汰率;用相同请求分别回放Python、C++和Dynamo-Triton输出;把用户、模型、特征版本写入缓存键;做一次跨租户隔离测试;最后以“每千次推荐节省的GPU毫秒”而非峰值倍数决策。若50%命中仍不能覆盖显存和复杂度,就先优化批处理或编译路径。
你的推荐请求中,有多少比例真的共享稳定的用户历史前缀?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。