AWS在9月30日用一个音乐生产案例展示AgentCore Runtime Instances:三个Agent共用GPU实例、会话和文件系统,先生成音频,再处理响度,最后独立合规检查。共享目录让交接变快,也让“谁写的、哪一版、有没有被改过”变成生产问题。我的核心判断是:共享存储必须配可验证的产物清单。
发生了什么
官方把Runtime Instances与MicroVM做了明确区分。后者是按用量计费的无服务器运行时,单会话最长8小时且一个运行时承载一个Agent;前者运行在客户账户的托管EC2上,可使用支持的GPU、持久EBS卷,一个实例承载多个Agent,会话最长14天。多个运行时使用同一容量提供者和runtimeSessionId时,会落到同一实例并共享挂载卷。
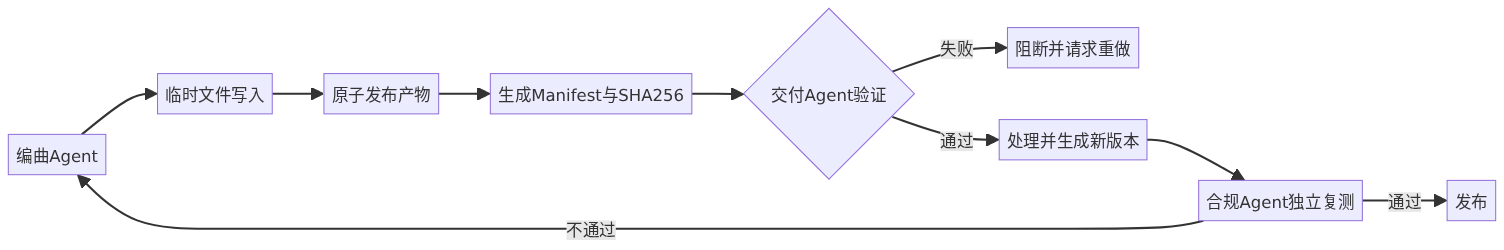
示例中,编曲Agent运行ACE-Step并写出音频;交付Agent读取文件、测量并处理;合规Agent重新测量,检查目标与历史曲库相似度,不合格就回叫编曲Agent重做。AWS报告L4上生成20秒、48 kHz立体声音频约需9秒。这是官方案例环境数据,不应外推到其他模型和GPU。
技术原理:共享目录不是工作流协议
仅约定/shared/final.wav很脆弱:上游重跑可能覆盖文件,下游可能读到写了一半的内容,暂停恢复后也难判断旧产物是否还能用。更稳的办法是“不可变产物加Manifest”:上游写临时文件,完成后原子重命名,再生成包含会话、阶段、版本、大小与哈希的清单;下游先验证再处理,并写自己的新清单。
最小实践:用哈希阻止被篡改的交接
下面只使用Python标准库。依赖安装:无;保存为artifact_handoff.py,运行python3 artifact_handoff.py。代码在临时目录生成产物、清单并校验,再模拟文件被改写。
import hashlib, json, tempfile
from pathlib import Path

def sha256(path: Path) -> str:
    return hashlib.sha256(path.read_bytes()).hexdigest()

def publish(root: Path, session: str, payload: bytes) -> Path:
    artifact = root / "mix-v1.wav"
    artifact.write_bytes(payload)
    manifest = {
        "session": session,
        "stage": "compose",
        "artifact": artifact.name,
        "bytes": artifact.stat().st_size,
        "sha256": sha256(artifact),
    }
    target = root / "mix-v1.manifest.json"
    target.write_text(json.dumps(manifest), encoding="utf-8")
    return target

def verify(root: Path, manifest_path: Path, session: str) -> bool:
    m = json.loads(manifest_path.read_text(encoding="utf-8"))
    artifact = root / m["artifact"]
    return all([
        m["session"] == session,
        artifact.stat().st_size == m["bytes"],
        sha256(artifact) == m["sha256"],
    ])

with tempfile.TemporaryDirectory() as folder:
    root = Path(folder)
    manifest = publish(root, "session-42", b"audio-v1")
    assert verify(root, manifest, "session-42")
    (root / "mix-v1.wav").write_bytes(b"tampered")
    assert not verify(root, manifest, "session-42")
    print("handoff gate passed")
publish固定了会话与阶段并计算SHA-256摘要;verify同时检查会话、大小和内容;文件被改写后门禁必须失败。代码已在本次任务中使用Python 3.9实际运行,输出handoff gate passed且两条断言通过。本次没有AWS账户、L4 GPU或AgentCore权限,未部署官方三Agent案例,也未生成真实音频。
一个具体场景
把音乐换成软件发布:构建Agent生成容器镜像清单,测试Agent读取同一会话产物并附上报告,安全Agent独立核对扫描结果后签名。它们可以各自部署,不必同时升级;但清单格式必须向后兼容。若安全Agent只相信文件名,不验证摘要,上游被覆盖或路径碰撞就可能绕过检查。
暂停与恢复要有明确语义
长任务最麻烦的不是运行,而是隔夜恢复。恢复前要判断上一次阶段是“完成并发布”“正在写入”还是“已经失败”。清单可增加状态、生产者版本、输入摘要和单调递增序号;只有状态为published且输入摘要仍一致时,下游才能继续。若最后一次心跳停在写入阶段,应清理临时文件并从该阶段重跑,不能猜测文件是否完整。
幂等性同样重要。同一调用因网络超时被重试时,上游应得到相同产物标识,或明确生成新版本;下游消费成功后写入收据,避免同一结果被处理两次。对于会产生费用、发送消息或改数据库的动作,共享文件只能做协调证据,最终还需要事务键或外部系统的幂等令牌。
如果多个团队独立升级,Manifest本身要版本化。新增可选字段通常能向后兼容,删除或改义则应升主版本,并在下游明确拒绝未知主版本。这样共享卷才从“大家都能看见的目录”变成可演进的接口。
我的判断及依据
Runtime Instances提供的是长时间、共享GPU和共享卷的能力,不自动提供正确的跨Agent交接语义。官方示例最值得迁移的也不是“用三个Agent做音乐”,而是生成、处理、独立复核的职责分离。再加不可变清单,就能把口头约定变成机器可验证的接口。
边界与风险
官方说明恢复会话依赖落在同一可用区,14天也不是永久保存承诺。共享进程空间和文件系统会扩大故障与权限影响面;不同团队独立发布时还可能造成格式漂移。哈希只能证明内容未变,不能证明内容安全或作者可信,生产环境还需要身份签名、最小权限、加密、配额、恶意文件扫描和审计日志。
立即可执行的检查表
为每个会话生成不可猜测ID;产物先写临时名再原子发布;清单包含生产者版本、输入摘要、输出摘要和时间;下游验证后才打开文件;每阶段写新版本而非覆盖;设置会话到期和清理策略;故障演练至少覆盖中途写入、重复调用、旧清单、跨会话误读和磁盘满。云上试验结束后,还要删除容量提供者、镜像、存储与相关权限,避免持续费用。
你的多Agent工作流里,产物交接现在靠文件名、数据库记录,还是可验证清单?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。