
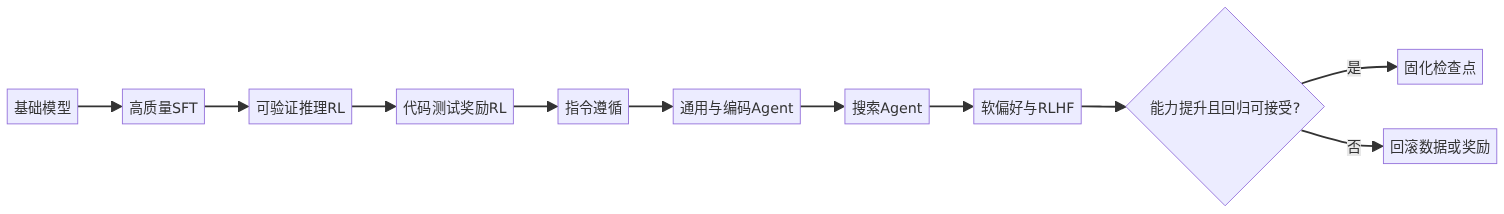
9月24日,Amazon团队公开Rufus-Air:在GLM-4.5-Air-Base上串联八个后训练阶段,从监督微调到推理、代码、指令、通用Agent、编码Agent、搜索Agent和RLHF。最值得开发者拿走的并不是照抄八步,而是一条更稳的原则:先用能明确判对错的奖励建立能力,再逐步引入主观裁判;每一步都必须过回归门禁。
发生了什么
论文称这套配方基于106B-A12B基础模型,记录了数据、奖励设计、基础设施、阶段顺序与逐阶段结果。训练主要使用开源组件和公开数据,没有新增人工标注,也没有内部蒸馏教师。作者总结:高质量且多样的监督微调(SFT,Supervised Fine-Tuning)建立能力下限;难度过滤让强化学习样本处在有效区间;奖励可靠性决定阶段排序;基础设施也是配方的一部分。
这些都是论文团队的实验结论。Rufus-Air优于官方GLM-4.5-Air后训练版本并与同规模开放模型有竞争力,不意味着八阶段对所有基础模型、预算和语言都最优。47页论文与20张表提高了透明度,但完整复现仍需要巨大算力和严格的数据版本控制。
技术原理:为什么奖励要“先硬后软”
数学题最终答案、代码单元测试和格式约束通常能自动验证,噪声相对小;搜索质量、帮助程度和表达偏好往往依赖模型裁判或人工规则,误差更大。早期模型若被含糊奖励牵引,很可能学会讨好裁判,而不是学会任务本身。先训练可验证能力,相当于先把尺子校准,再测柔软材料。
难度过滤同样关键。题目太简单,所有样本奖励都接近满分,梯度没有信息;题目太难,奖励长期为零,模型也不知道哪个尝试更好。有效训练区间应持续监控通过率、奖励方差和失败类型,而不是固定拿一套数据跑到底。
阶段之间还存在“能力覆盖”风险。代码阶段提高了测试通过率,可能同时让回答变得过度模板化;搜索阶段学会引用网页,也可能放大对低质量来源的依赖。因此每一阶段都应同时看目标能力、通用能力、安全性和校准度,不能只追一条上升曲线。
最小实践:给阶段加晋级门禁
下面的纯Python脚本不训练模型,而是演示阶段门禁:核心能力必须提升,安全与通用能力的回退不能超过阈值,软奖励阶段还要满足更严格的最低样本量。保存为gate.py后运行python gate.py。
from dataclasses import dataclass

@dataclass
class Stage:
    name: str
    reward: str
    samples: int
    target_gain: float
    general_delta: float
    safety_delta: float

def promote(stage: Stage) -> tuple[bool, list[str]]:
    problems = []
    if stage.target_gain < 0.02:
        problems.append("目标能力提升不足2%")
    if stage.general_delta < -0.01:
        problems.append("通用能力回退超过1%")
    if stage.safety_delta < -0.005:
        problems.append("安全指标回退超过0.5%")
    if stage.reward == "soft" and stage.samples < 1000:
        problems.append("软奖励样本不足1000")
    return not problems, problems

stages = [
    Stage("代码RL", "hard", 800, 0.05, -0.004, 0.001),
    Stage("偏好RLHF", "soft", 600, 0.03, 0.002, -0.007),
]
for stage in stages:
    ok, reasons = promote(stage)
    print(stage.name, "PROMOTE" if ok else "HOLD", reasons)
本次已在Python 3.9运行:代码RL通过,偏好RLHF因软奖励样本不足且安全指标回退被暂停。阈值是教学示例,不来自Rufus-Air,也不能直接用于生产。关键是把晋级条件写成可审计配置,并为每个检查点保存数据版本、奖励版本和评测报告。
开发者应该关注什么
第一,不要只保存最终模型。若第七阶段出现退化,没有逐阶段检查点就无法定位来源。第二,训练指标不能替代留出评测;奖励上涨可能只是学会了裁判偏好。第三,代码和搜索Agent需要真实工具环境,沙箱版本、超时、网络权限和测试稳定性都会改变奖励。第四,阶段顺序不是永恒真理;新基础模型已经具备的能力不同,应该用诊断结果删减或重排。
一个可执行流程是:先为每个阶段写“想新增什么能力、可能伤害什么能力”;建立冻结的核心留出集与动态污染检查;训练后比较目标收益、通用回归、安全回归和单位算力收益;只在四项门禁都满足时晋级。软裁判阶段应抽样人工复核,并用多个裁判检查排序一致性。
还应设置停止条件。若连续两个检查点的目标收益低于噪声区间,或单位GPU小时收益快速下降,就暂停扩训并复查数据;继续堆步数可能只会强化奖励漏洞。对于可恢复的退化,优先从最近通过门禁的检查点重启,而不是用最终模型反向猜原因。
我的判断与边界
Rufus-Air把行业常被省略的工程细节放回配方:数据怎么选、奖励为何可信、阶段为什么这样排、基础设施怎样保持轨迹可复现。这比又一个总榜分数更有长期价值。不过“开放”不等于低成本,也不等于没有数据许可和污染风险。中小团队更现实的做法不是复刻106B训练,而是复用奖励排序、难度过滤、逐阶段门禁和可回滚检查点。
你的模型训练失败时,最先排查数据、奖励可靠性,还是直接增加算力和训练轮数?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。