企业机器学习最常见的不是聊天,而是拿订单、传感器和客户表格预测流失、违约或需求。NVIDIA Kumo Tabular 的新意,是让标注行直接成为上下文,一次前向计算预测新行,不再为每个任务重新训练。但“零训练”省掉的是拟合步骤,不是业务验收。
发生了什么
NVIDIA 团队 9 月 29 日发布 Kumo Tabular 开放模型与 GPU 原生 structured-data-models 库。模型有 28M 到 215M 三种规模,只用人工生成的表格预训练,支持分类与回归。官方称其在 TabArena、BeyondArena、TALENT 和 ScoringBench 四组评测上排名第一,并在统一 RTX 6000 Pro 环境下相对 LimiX-2 快 17 倍。
这些是发布方结果,值得关注,但不能直接写进采购结论。官方也明确:模型只原生处理数值和类别列;单次前向覆盖最多 10 类,更多类别由纠错输出码扩展;真实表格远超训练分布,或查询行与上下文分布不一致时,准确率会下降。
技术原理:把训练集放进上下文
传统梯度提升树会在你的数据上优化参数;Kumo 把已标注行作为 in-context examples(上下文示例),通过列注意力理解一个值在整列中的位置,通过行注意力学习特征交互,再让待预测行只关注上下文行。上下文的键值可以缓存,后续查询不必重复计算。
数值和类别值先经过 Fourier 特征编码,缺失值被单独处理;回归头输出 999 个分位数,因此不只给点预测,还能表达不确定性。预训练表格由结构因果模型生成,主动加入缺失、重复冲突、高基数类别和重尾目标。优点是覆盖广,风险是合成机制仍可能漏掉你所在行业的真实偏差。
最小实践:门禁先于模型替换
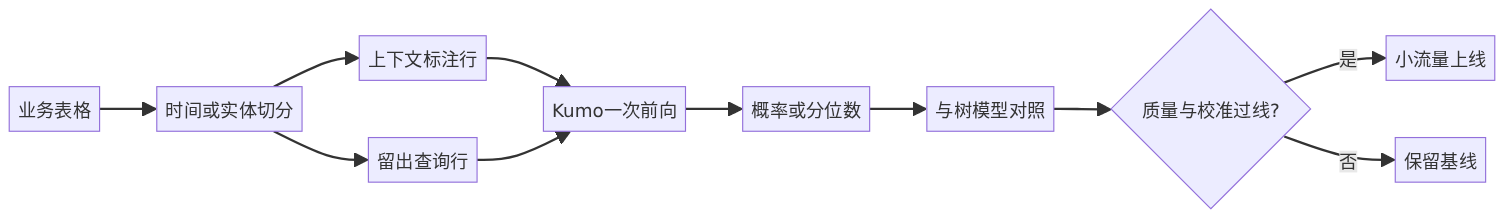
本文验收脚本只用 Python 标准库,无需额外依赖。Kumo 官方库要求 Python 3.11、PyTorch 2.7 及 GPU,安装命令为 pip install git+https://github.com/NVIDIA/structured-data-models.git。下面用一小组预测演示门禁;实际使用时应替换为按时间或实体隔离的留出集,要求候选模型的平衡准确率不下降、Brier 校准误差不增加超过 0.02。
rows = [  # y, baseline_probability, kumo_probability
    (0, .20, .10), (0, .35, .20), (0, .55, .40),
    (0, .40, .25), (0, .30, .35), (0, .10, .15),
    (1, .60, .70), (1, .45, .65), (1, .70, .80),
    (1, .80, .75), (1, .52, .45), (1, .40, .60),
]

def metrics(column):
    y = [row[0] for row in rows]
    p = [row[column] for row in rows]
    positives = [i for i, label in enumerate(y) if label == 1]
    negatives = [i for i, label in enumerate(y) if label == 0]
    tpr = sum(p[i] >= .5 for i in positives) / len(positives)
    tnr = sum(p[i] < .5 for i in negatives) / len(negatives)
    brier = sum((p[i] - y[i]) ** 2 for i in range(len(y))) / len(y)
    return {"balanced_accuracy": (tpr + tnr) / 2, "brier": brier}

baseline, candidate = metrics(1), metrics(2)
passed = (candidate["balanced_accuracy"] >= baseline["balanced_accuracy"]
          and candidate["brier"] <= baseline["brier"] + .02)
print({"baseline": baseline, "kumo": candidate, "passed": passed})
if not passed:
    raise SystemExit("BLOCK: keep the existing production model")
运行 python gate.py。本次用 12 条合成留出数据在 Python 3.9.6 实际执行,候选平衡准确率 0.917、Brier 分数 0.100,对照分别为 0.750 和 0.159,门禁通过。注意:这只验证验收逻辑;本次没有 GPU,未下载 Kumo 权重,也没有复现官方排行榜。
普通人和开发者会感受到什么
具体价值在冷启动:一家小工厂只有几百条已标注故障记录,团队可以先得到可用基线,再决定是否值得做长期特征工程。对数据科学家,角色不会消失,工作重点会从“每次从零调参”转向切分、防泄漏、校准、漂移与解释。
我的判断是,表格基础模型最可能先替代脆弱的 AutoML 起点,而不是立即替代经过多年治理的信用、医疗或风控模型。排行榜通常随机切分,生产数据却沿时间、地区和客户变化。立即可执行的动作是按时间留出最近一个周期,再按关键人群分层查看误差;不要让同一客户的近似记录同时进入上下文和测试集。
边界与检查表
上线前检查许可与版本固定;比较 GPU 成本和树模型 CPU 成本;测 10 类以上、文本和时间字段的预处理;保存上下文行版本;给概率做校准;监控输入分布;对高风险决策保留人工复核。零训练不是零数据治理,更不是零责任。
如果零训练模型只在冷启动阶段胜出,你会把它当最终模型,还是自动化基线?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。