一个Agent交出正确答案,不代表它走得对。它可能搜索了五次、把同一文件读了三遍,甚至在失败后悄悄换了路径。你读完会掌握一个长期有用的基础概念:怎样用“开始—结束”事件还原工具调用,并把结果验证与过程证据分开。
最新事件:答案之外,NVIDIA开始教开发者看路径
NVIDIA在2026年9月30日发布NeMo Relay教程,展示Hermes Agent如何输出三类轨迹:Agent Trajectory Observability Format(ATOF,Agent轨迹可观测格式)的JSONL生命周期事件、Agent Trajectory Interchange Format(ATIF,Agent轨迹交换格式)的逐步记录,以及带OpenInference语义的OpenTelemetry链路。官方案例还把确定性验证器与轨迹放在一起:任务是否完成是一条证据,调用次数、错误、耗时和Token消耗是另一条证据。
这不是“多打一份日志”。它解决的是:当答案正确但成本突然翻倍,或答案错误但工具实际执行成功时,团队能否定位问题究竟在模型、工具、编排器还是验证器。
生活类比:快递签收照不等于运输记录
最终答案像一张签收照,只能说明包裹最后出现了。轨迹像每次入库、出库和转运扫描;同一运单号把动作串起来,父运单号说明它属于哪一批任务。类比的边界是:物流节点通常确定,而Agent会根据模型输出动态决定下一步,重试也可能改变参数,所以轨迹还必须记录输入、输出、错误与版本。
去掉类比后的准确定义
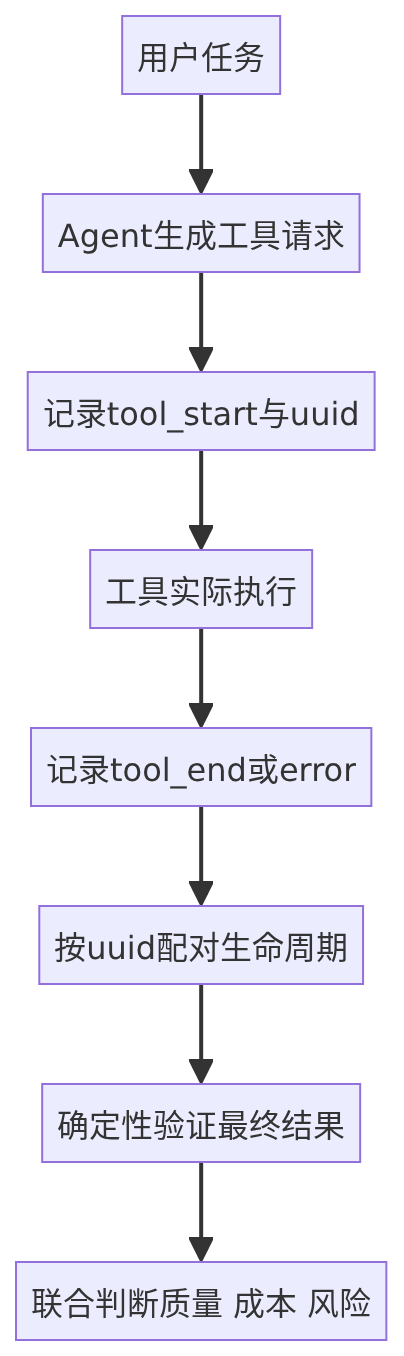
Agent轨迹是一组按时间排序、带关联标识的执行事件。一次工具调用至少应有共享唯一标识符的开始和结束事件;parent_uuid把它挂到所属模型回合或任务。轨迹回答“实际发生了什么”,验证器回答“结果是否满足任务要求”。二者不能互相替代:只有请求记录不能证明工具成功,只有最终断言也看不见重复调用和失败恢复。
读真实轨迹时,可以从失败向上追:先找错误结束事件,再用相同uuid定位开始参数,接着沿parent_uuid回到触发它的模型回合,最后核对后续是否发生了重试或降级。这样既能发现工具故障,也能区分“模型重复下令”和“编排器自动重试”。若只按时间扫日志,两种原因很容易被混为一谈。
最小实践:找出未闭合调用与重复重试
下面用标准库解析一份简化JSONL。依赖安装:无;保存为trace_check.py后运行python3 trace_check.py。代码既检查开始与结束是否成对,也按工具名统计调用和错误。
import json
from collections import Counter

raw = """{"event":"tool_start","uuid":"a1","tool":"search"}
{"event":"tool_end","uuid":"a1","tool":"search","error":null}
{"event":"tool_start","uuid":"a2","tool":"search"}
{"event":"tool_end","uuid":"a2","tool":"search","error":"timeout"}
{"event":"tool_start","uuid":"a3","tool":"search"}
{"event":"tool_end","uuid":"a3","tool":"search","error":null}
{"event":"tool_start","uuid":"b1","tool":"write"}"""

events = [json.loads(line) for line in raw.splitlines()]
starts = {e["uuid"]: e for e in events if e["event"] == "tool_start"}
ends = {e["uuid"]: e for e in events if e["event"] == "tool_end"}

calls = Counter(e["tool"] for e in starts.values())
errors = Counter(e["tool"] for e in ends.values() if e.get("error"))
unclosed = sorted(set(starts) - set(ends))

print("calls", dict(calls))
print("errors", dict(errors))
print("unclosed", unclosed)
assert calls["search"] == 3
assert errors["search"] == 1
assert unclosed == ["b1"]
关键有三段:先按uuid分别建立开始和结束索引;再统计工具频次与错误;最后把只有开始、没有结束的调用列为未闭合。本文示例已于本次任务中使用Python 3.9实际运行,三条断言通过;它验证的是解析逻辑,不代表已安装或运行NeMo Relay、Hermes Agent、Phoenix,也不复现官方108次ToolPerf实验。
三个常见误区
第一,认为有ATIF里的工具请求就等于工具执行成功。请求是意图,结束事件与错误字段才是执行证据。第二,只追求更少调用。少调用可能来自提前放弃,必须与结果验证同时看。第三,把完整提示词、工具参数和文件路径直接上报公共监控。轨迹可能含密钥、个人信息和内部目录,采集前要脱敏、分级保留并限制访问。第四,把一次漂亮轨迹当成系统结论;非确定性Agent至少要在固定任务集上重复运行,再比较成功率、P95耗时、错误和成本。
适用与不适用
它适合会调用搜索、终端、文件、浏览器或MCP工具的Agent,也适合评估编排器升级。纯文本、单次且无外部动作的简单问答,完整事件链收益可能低于采集成本。安全审计场景还不能只靠应用日志;操作系统、身份、网络和数据访问日志仍需独立保存。
我的判断
未来Agent评测的基本单位不会只是“答案”,而是“结果加轨迹”。NVIDIA这次更新真正值得学的不是某个格式名,而是证据分层:确定性验证器守住任务底线,事件链解释过程,聚合指标判断版本是否变好。团队最先要建的也不是华丽看板,而是稳定的调用ID、开始/结束配对和失败原因分类。
当这三项稳定后,再接入可视化系统也不迟;否则漂亮的瀑布图只是把不完整证据放大。
5分钟实践题
把示例中的第三次search结束事件删除,再增加一次write成功事件。运行脚本,解释为什么“未闭合数量”变化了,但“搜索错误数”没有变化。然后为同一工具连续调用超过两次增加一个possible_retry提示。
你的Agent最需要先追踪错误、重试、耗时,还是Token成本?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。