一家大型银行计划让半数开发人员在年底前用上Claude Code,这是强烈的采用信号,但还不是“生产力提高了多少”的证据。对开发者更有价值的判断是:当代码生成更便宜,需求澄清、测试设计、系统边界和可审计证据会变得更稀缺。
公告中真正可核验的数字
Anthropic在2026年10月1日宣布与Barclays扩大合作。按官方披露,Barclays预计Claude Code在2026年底覆盖50%的开发人员,2027年扩大到大多数软件工程师。该行的Colleague Knowledge Assistant自2025年起运行,采用检索增强生成(RAG)架构,已有超过16000名员工使用,处理超过100万次搜索,面向超过2000万英国零售客户的服务。
在全球市场业务中,Claude模型用于对客户来信分类、丰富信息并选择处理路由,官方称平台每天处理约12万封邮件。这些数字证明部署规模与工作流覆盖,不自动证明准确率、漏报率、客户等待时间或软件缺陷率已改善。这是阅读厂商合作公告时必须守住的边界。
另一个容易误读的数字是“100万次搜索”。它说明员工确实在使用,却不告诉我们每次答案是否找到正确制度、是否引用当前版本,或员工最终是否仍需要人工搜索。真正的RAG评估至少应分开检索召回、答案忠实度、文档新鲜度、权限泄漏与员工改判率。只有搜索量,无法分辨“很好用”和“不得不反复问”。
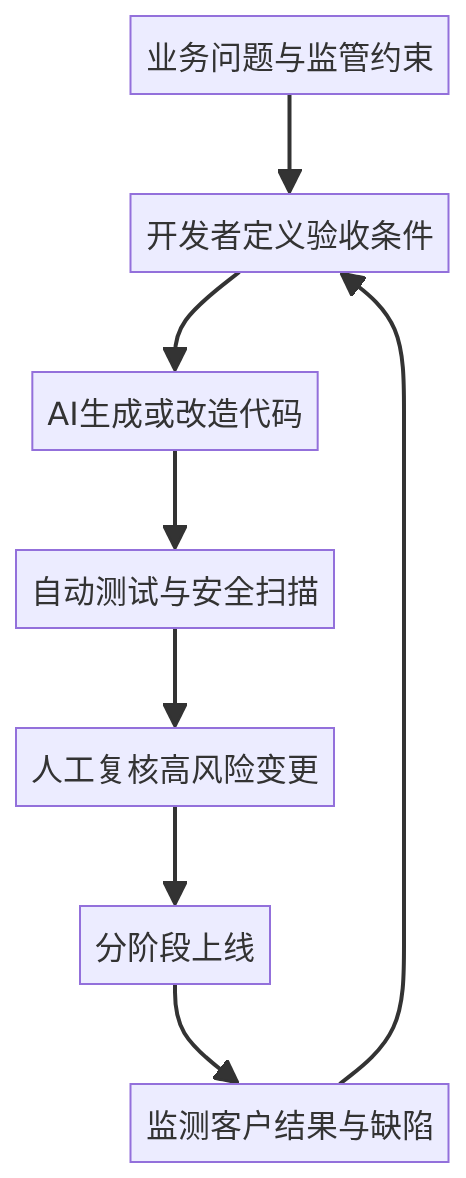
从“写代码”到“证明变更可以上线”
银行的遗留系统不是单个旧编程语言问题。它通常同时携带历史业务规则、批处理时窗、下游报表契约、监管留痕和稀缺的隐性知识。AI可以加快代码阅读、测试初稿和重构候选,却不知道某个看似多余的分支是否对应一条监管义务。
因此,工程岗位会从代码产出向责任链重心转移:能否把含糊需求改成可验收条件,能否构造金额边界、幂等重试、权限分离和数据回放测试,能否解释模型生成的迁移计划为什么不破坏日终批处理。这些都不是“提示词写得更像命令”可以取代的能力。
代码审查的工作也会改变。审查者不能只问语法是否正确,而要核对生成代码所依赖的需求版本、数据范围、失败语义与监控信号。AI很擅长补全局部模式,也容易把一个在新服务里常见的做法套到不允许相同失败方式的老系统。熟悉历史事故和业务不变式的人,会比单纯写得快的人更有价值。
具体场景:邮件路由不能只看平均准确率
假设每天12万封邮件里,99%是普通查询,1%是时效严格的交易指令。一个模型只要把普通查询处理得很好,整体准确率就可以很高;但少量关键邮件的漏报仍可能造成重大损失。工程团队要分类看召回率、错误路由、人工改判和最坏处理延迟,还要对高风险类别设置失败关闭,不能被一个宏观数字说服。
对开发者和管理者的行动建议
开发者现在可以主动练四件事。第一,把业务规则变成可执行测试,尤其是金额、日期、幂等和权限边界。第二,为AI产出保留来源、审批人、测试证据与回滚路径。第三,学会按风险分类评估,别只上报平均工时或生成行数。第四,把遗留知识写成文档、架构决策记录和运行手册,否则AI只会更快地猜。
管理者则应把采用率与效果指标分开:多少人用AI,是推广指标;从需求到生产的周期、逃逸缺陷、安全事件、回滚率和客户等待时间,才是工程与业务结果。
更可行的度量设计是分阶段做对照。先在同类任务中比较交付周期、评审往返次数和测试失败,再追踪上线后的缺陷与回滚,同时记录模型、工具、任务类型和开发者经验。如果只看“用了AI的PR数”,团队很可能奖励使用量,而不是更安全、更有价值的软件。
我的判断与风险
Barclays案例说明,AI已从个人试用进入受监管机构的系统性部署。但职业结论不应是“工程师将被替代”或“人只负责创意”。更准确的说法是,代码初稿的稀缺性下降,而能对真实系统后果负责的人更重要。由于该文来自Anthropic与客户的合作公告,成本、准确率、缺陷率、安全事件和经对照的生产力收益都需等待独立数据。
本文未提供代码,因为核心是职业与治理判断,没有可以不借助Barclays内部数据就证明部署效果的合理演示;强行添加API样例会偏离文章结论。
如果团队明年让半数开发者高频使用AI,你最想先补测试、文档、权限,还是效果指标?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。