模型服务返回 200、token 也很流畅,不代表它按模型作者的设定在运行。真正危险的是“静默配置漂移”:模型文件声明一个值,推理引擎最终消费了另一个默认值。开发者应把有效配置当成可验证产物,而不是相信启动命令已经生效。
发生了什么
9 月 25 日发布在 Hugging Face 的 Entail 项目报告称,它检查了 Hub 下载量靠前的 300 个文本生成模型。其中 180 个会接受 vLLM 启动时的 rope_scaling 覆盖,64 个因此改变了 RoPE 基数。RoPE 是 Rotary Position Embedding,中文常译旋转位置编码,用来把位置信息注入注意力计算。
发布者在单张 RTX 4070 Ti 上给出端到端结果:Llama-3.2-3B-Instruct 在前 500 道 GSM8K 上由 379 道正确降到 273,道路上没有警告;Qwen3-4B-Instruct-2507 在 YaRN 路径下由 183 降到 175。数字来自项目作者的一台 GPU 和公开脚本,不应外推为所有版本、模型和硬件的固定损失,但复现实验、原始结果和上游 issue 均已公开。
技术原理:声明链断在了哪里
模型目录里不只有权重。config.json、tokenizer、Safetensors 元数据和聊天模板共同声明位置编码、滑动窗口、嵌入绑定、采样预测类型等运行条件。启动器读取声明,合并命令行覆盖,再传给加载器、注意力后端、缓存和渲染器。若“覆盖”采用整块替换而非字段合并,未重复写出的 rope_theta 就可能消失,运行时随后使用默认值。
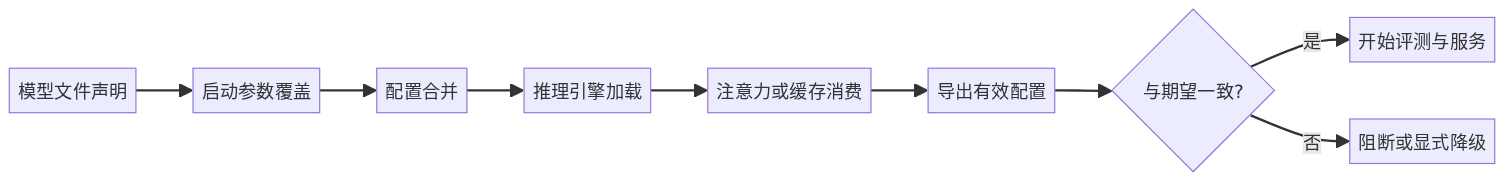
这里的核心判断是:模型评测不能替代配置对账。原文另一组 Gemma 2 实验里,不同后端的总分接近,但 500 个答案中有 198 个不同;聚合分数会把样本级漂移平均掉。健康检查也只能证明进程活着,不能证明关键声明到达了消费点。
最小实践:启动前对账关键字段
下面模拟模型声明与引擎有效配置。真实系统应从模型目录和运行时诊断接口分别读取,而不是手填字典。
expected = {
    "rope_theta": 150000,
    "rope_scaling.type": "yarn",
    "sliding_window": 32768,
}
effective = {
    "rope_theta": 10000,
    "rope_scaling.type": "yarn",
    "sliding_window": 32768,
}
critical = {"rope_theta", "rope_scaling.type", "sliding_window"}

def preflight(want, got, required):
    report = []
    for key in sorted(required):
        if key not in want:
            report.append((key, "unknown_expected", None, got.get(key)))
        elif key not in got:
            report.append((key, "missing_runtime", want[key], None))
        elif want[key] != got[key]:
            report.append((key, "mismatch", want[key], got[key]))
    return report

problems = preflight(expected, effective, critical)
for row in problems:
    print(row)
assert problems == [("rope_theta", "mismatch", 150000, 10000)]
print("gate=BLOCK" if problems else "gate=PASS")
依赖只有 Python 标准库,保存为 config_gate.py 后运行 python config_gate.py。本次在 Python 3.9 实际运行,识别到 rope_theta 从 150000 变成 10000,门禁输出 BLOCK,断言通过。本次没有安装 Entail,也没有在 GPU 上复跑作者的模型评测;正文不会把本地字典演示写成对项目结果的独立复现。
开发者应该怎样落地
第一,部署清单同时保存模型仓库 revision、推理引擎版本、启动参数和“有效配置快照”。第二,对位置编码、聊天模板、滑动窗口、量化方案和缓存长度建立按模型分类的关键字段表。第三,先跑预检,再跑少量确定性金样本,最后才做吞吐压测。配置门禁解决声明丢失,金样本发现行为漂移,两者不能互相替代。
Entail 的思路是把检查点放到真实消费边界,能修复有测量依据的差异,否则报告 broken 或 unknown。作者也明确披露边界:它回放 12 个真实输出 bug 时,8 个能在目标显卡复现,但工具一个都没抓到;内核算术、解析器逻辑和生命周期错误不在当前覆盖范围。工具不是“部署正确证明书”。
适用边界与风险
这套对账适合多模型、多引擎、频繁升级的推理平台,尤其是长上下文和自定义覆盖较多的服务。只有单一固定镜像的小应用也值得保存快照,但未必需要引入运行时钩子。自动修复必须谨慎:当配置冲突涉及质量与成本取舍时,默认阻断通常比悄悄改值更安全。
一套更完整的发布门禁可以分三档。第一档在 CPU 上解析模型元数据并比较静态配置,成本最低;第二档加载模型后导出注意力后端、上下文长度和缓存配置,确认真实消费值;第三档用固定随机种子运行少量边界样本,包括短输入、接近最大上下文和结构化输出。只有第三档失败时,团队才能进一步判断是配置、内核还是模板问题。
还要防止“配置快照本身不可比”。字典顺序、浮点表示和路径会制造无意义差异,应先规范化再做哈希;密钥、访问令牌和本地目录必须从快照中剔除。对无法识别的新字段,不要静默忽略,记录为 unknown 并要求负责人决定是否升级规则。这样门禁才不会在新模型出现时假装一切正常。
我的判断是,未来模型可移植性竞争的重点会从“权重能不能加载”转向“声明能否完整抵达每个消费点”。今天最值得做的动作,是给生产服务增加一次启动后配置导出,并把它纳入版本差异审查。
你上线模型时会保存有效运行配置,还是只保存启动命令和模型名?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。