
联邦学习常被概括成“数据不出本地”,但真正落地时,机构间连算力平台都不一样。NVIDIA 9月15日介绍FLARE 2.9:同一个联邦里,医院可以用Docker,云端用Kubernetes,高校GPU中心用Slurm。关键不是新增一个启动参数,而是把长期在线的协调层与临时训练作业彻底分开。
发生了什么
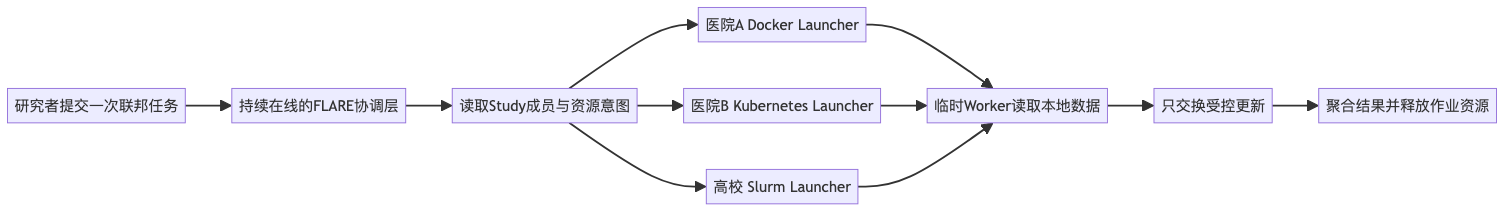
官方资料显示,FLARE 2.8已加入Docker和Kubernetes部署支持,2.9进一步支持Slurm高性能计算调度。长期运行的服务端与客户端父进程负责认证、维持联邦关系和协调任务;真正消耗GPU的Server Worker与Client Worker只在作业到来时创建,完成后退出。
任务描述GPU、CPU调度单元和主机内存等“资源意图”,各站点的Launcher再把它翻译成本地容器、Pod或Slurm allocation。Study机制则提供逻辑多租户边界,站点可以为不同研究映射自己的数据集、密钥、允许镜像和调度策略。
技术原理
这套设计像把“值班前台”和“实际手术室”分开。前台一直在线确认身份和安排时段,却不占用昂贵手术设备;任务真正开始时,参与方才按本院制度准备房间。类比的边界是:联邦训练还涉及参数更新、攻击面和统计偏差,不只是预约资源。
准确地说,解耦解决的是控制平面与执行平面的生命周期差异。协调服务需要稳定连接,训练进程需要弹性GPU。若两者绑死,维持联邦连接就可能长期占卡,任一站点升级运行环境也会牵动全网。现在各站点保留资源决定权,联邦任务只声明需求,不直接越过本地调度器。
对开发者和机构的影响
一个具体场景是三家医院与一所大学共同训练影像模型。医院A只有受管Docker主机,医院B运行Kubernetes,大学计算中心要求所有任务进入Slurm队列。过去项目组往往先花数月统一平台;现在可统一联邦协议和研究配置,同时让各方保留本地镜像审批、密钥系统和排队规则。
开发者要付出的代价是更严格的可移植性。训练镜像必须兼容列出的GPU与驱动,数据路径不能写死,失败重试需要幂等;同一作业在某站点排队两小时、另一站点立即启动时,聚合器还要处理超时和掉队参与方。
跨后端还会放大可观测性难题。Docker日志、Kubernetes事件与Slurm作业状态使用不同术语,中央协调器若只显示“客户端离线”,运维人员很难判断是镜像拉取失败、队列等待还是本地策略拒绝。项目至少需要统一作业ID、阶段、错误类别和时间戳,同时允许站点隐藏敏感基础设施细节。
我的判断与边界
我的判断是,联邦学习规模化的第一道墙经常是组织和运维异构,而非新的聚合算法。把执行后端留给站点选择,能降低合作的前置改造成本,也更符合“本地拥有资源权”的治理原则。
但异构运行时不等于隐私证明。原始数据不移动,梯度或模型更新仍可能泄露信息;恶意参与方、数据投毒、样本分布偏差和密钥轮换仍需单独处理。Study是逻辑隔离,不应在没有验证的情况下等同于强安全边界。官方文章也没有给出跨后端的性能损耗、故障率或独立生产基准,因此不能声称升级后训练一定更快。
此外,各站点使用不同GPU与批量设置,会让每轮本地更新耗时和数值行为不一致。聚合策略若默认所有参与方等速、等质,可能让慢站点长期被排除,最终模型偏向资源更强的机构。性能公平和数据代表性需要一起监控。
可立即执行的检查表
- 先列出每个站点的运行时、GPU类型、驱动、网络出口与排队策略。
- 把资源需求写成可移植意图,避免在训练代码里绑定本地节点名。
- 为每个Study单独映射数据、密钥、镜像白名单和成员权限。
- 演练某一参与方延迟、退出和重复提交,确认聚合过程可恢复。
- 对更新做裁剪、异常检测与必要的隐私保护,不把“不搬数据”当完整安全方案。
- 分别记录等待时间、实际训练时间和通信时间,识别真正瓶颈。
如果各方没有明确的数据责任、模型所有权和事件响应协议,不适合仅靠工具启动联合训练;先把治理合同写清楚,比接通三个调度器更重要。
跨机构训练中,你认为最难统一的是数据标准、算力环境还是治理责任?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。