
AI基础设施的新瓶颈不只是GPU,而是园区能拿到多少稳定电力。NVIDIA 9月15日公布的两个现场结果说明:把任务优先级、机架功率和电网信号放进同一套调度系统,既能在用电紧张时主动降载,也可能在不扩容电力的前提下提高Token吞吐。对云厂商和大模型团队来说,这比单看芯片峰值更接近真实产能。
发生了什么
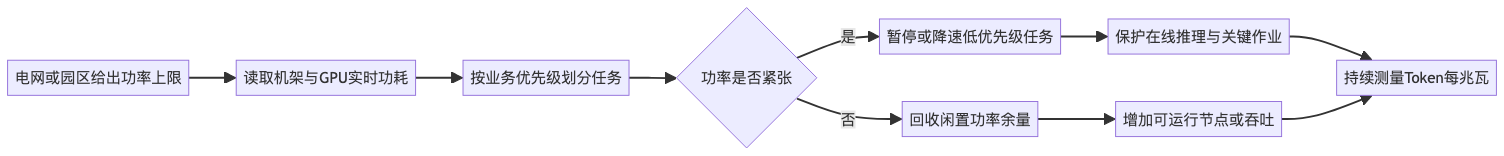
在加州圣克拉拉,NVIDIA的Eos AI工厂接收Silicon Valley Power发出的需求响应信号。合作方Emerald AI的Conductor平台按预先定义的工作负载等级,让可等待任务降速或改期,同时维持高优先级推理。官方称系统已响应超过200次信号;一次展示中,功率在一分钟内从4兆瓦降到3兆瓦。
另一组结果来自GPU云厂商Lambda。它在五个机架、19个节点上测试DSX MaxLPS:19个节点以约85%的功率策略运行,与16个满功率节点保持相同设施预算。NVIDIA披露,集群吞吐从约每秒400万Token升至500万,增加24%,每瓦性能提升23%。这些是合作方在特定HGX B200环境中的结果,不应外推为任意模型、集群和电价条件下的固定收益。
技术上真正改变了什么
传统机房常按单机最坏功耗预留电力,优点是稳,代价是许多节点并不会同时达到峰值,形成“有GPU但不敢一起开”的搁浅容量。动态功率分配持续观察节点负载,把没有用满的功率余量转给需要的节点。训练与推理的功率曲线不同,批处理又比在线请求更容易延后,因此调度对象不只是硬件,还包括服务等级目标。
这里有三层控制:GPU和机架层负责功率封顶;集群层决定节点与作业的资源份额;设施层响应电网、制冷和价格事件。只优化其中一层会遇到反作用:降低GPU功率可能拉长任务时间,暂停训练可能造成检查点开销,在线推理若缺少容量保护则会抬高尾延迟。所谓“每兆瓦Token”,本质是把这些代价放进一个产出指标,而不是证明Token本身等价于有效工作。任务完成率和用户等待时间仍要单独核算,业务价值也不能省略。
对开发者和企业的影响
开发团队很快会感受到新的资源契约。过去提交作业只写GPU数量和显存,今后还可能写功率弹性、最晚完成时间、可否抢占和恢复成本。一次离线微调可以在电价高时暂停,但面向客户的实时Agent若被同样处理,就会直接违约。
具体场景是夜间生成一批商品描述:任务可在凌晨前完成,允许短暂停顿;而同一集群上的搜索问答要保证首Token延迟。调度器收到降载信号后,应先保存批处理检查点,再限制其功率,不能简单平均削减每张卡。
我的判断与边界
我的核心判断是:AI基础设施竞争正在从“买到多少GPU”转向“在电力、网络和延迟约束下交付多少可用任务”。这会让调度软件、检查点、队列设计和业务分级获得与芯片同等重要的位置,也可能使可延迟的训练任务成为电网调峰资源。
但官方数字仍有四个边界。第一,24%来自19节点对16节点的特定比较,不是单节点提速。第二,功率下降不等于总能耗同比例下降,任务延长会改变累计电量。第三,Token吞吐没有衡量答案质量与业务成功率。第四,NVIDIA称下一代适合环境可容纳更多GPU或获得更高吞吐,其中包含预测,需等待独立部署验证。
可立即执行的检查表
- 给训练、离线推理、在线推理分别标注可暂停时长与延迟目标。
- 记录节点实际功率而非只看额定功率,找出长期未使用的余量。
- 在小集群做80%、90%、100%功率上限对照,比较吞吐、耗时和能耗。
- 测试暂停、检查点和恢复,确认降载不会丢失数小时训练进度。
- 同时看每兆瓦Token、每任务成本、尾延迟和正确率,避免单指标优化。
- 把厂商结果视为假设,在自己的模型、批量与网络拓扑上复现。
若团队没有机架级遥测、任务优先级或可恢复检查点,不适合直接做自动电网响应;先完善可观测性更重要。若负载主要是毫秒级交易或医疗实时服务,也不应为追求电价收益频繁抢占。
如果算力必须随电价和电网波动,你会优先暂停训练、批处理还是在线推理?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。