GPT‑6.1 Sol 最吸引人的不是一个新榜单,而是“接近 Astra 的能力、更低的每任务成本”这个产品位置。但任何团队都不该因为官方说“约五分之一价格”就全量替换。你真正要测的是:自己的任务成功一次,要花多少钱、重试几次、需要多少人工复核。
发生了什么
OpenAI 在 9 月 29 日 DevDay 发布 GPT‑6.1 Sol。官方模型页确认 API 模型 ID 为 gpt-6.1-sol,标准价格是每百万输入 token 2 美元、缓存输入 0.10 美元、输出 10 美元;超过 272K 输入后,整个请求的输入与缓存费率翻倍,输出费率为 1.5 倍。模型支持 1,050,000 token 上下文、128,000 token 最大输出;工具调用应使用 Responses API。
发布方报告称,GPT‑6.1 Sol 在 DeepSWE 1.1 上以更低推理强度超过上一代 6.4 个百分点;OSWorld 2.0 离线集相对 GPT‑6 Sol 提升 7 个百分点;困难事实性集合中,低推理强度的含错回答比例从 11.4% 降到 7.7%。这些是官方评测,不等于你的仓库、界面和提示词会得到相同比例。
关键原理:单价不是每任务成本
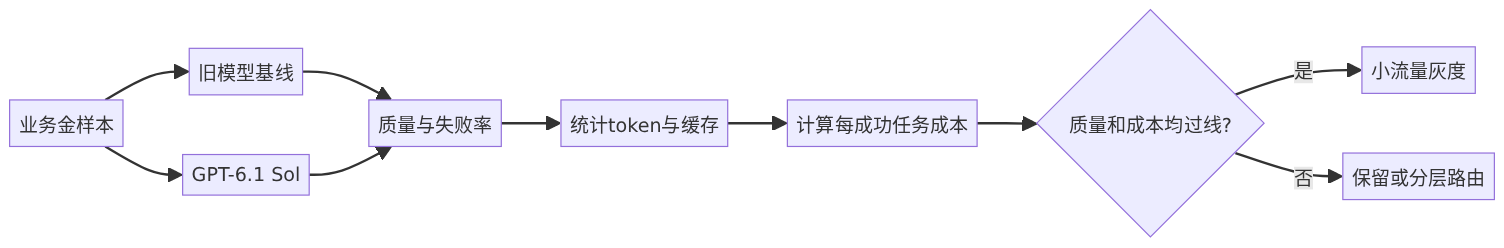
一次成功任务的真实成本,可近似写成:模型调用成本乘以平均尝试次数,再加工具、人工复核和失败损失。缓存输入便宜 95%,前提是重复前缀真的命中;如果每次把时间戳、随机 ID 放在系统提示开头,缓存优势可能消失。长上下文也不是免费保险,越过 272K 后全请求进入更高费率。
最小实践:先记录,再决定路由
安装依赖:pip install -U openai。密钥使用环境变量:export OPENAI_API_KEY="..."。下面的请求遵循当前官方 Responses API、模型 ID 和 reasoning.effort 参数;请用自己的 20—100 条任务集运行。
import os
from openai import OpenAI

MODEL = "gpt-6.1-sol"
INPUT_PER_M = 2.00
CACHED_PER_M = 0.10
OUTPUT_PER_M = 10.00

client = OpenAI(api_key=os.environ["OPENAI_API_KEY"])
response = client.responses.create(
    model=MODEL,
    reasoning={"effort": "medium"},
    input="检查下面函数的并发风险,并只返回三条可验证结论:...",
)

u = response.usage
cached = getattr(u.input_tokens_details, "cached_tokens", 0) or 0
fresh = u.input_tokens - cached
cost = (
    fresh * INPUT_PER_M
    + cached * CACHED_PER_M
    + u.output_tokens * OUTPUT_PER_M
) / 1_000_000

print(response.output_text)
print({"fresh": fresh, "cached": cached,
       "output": u.output_tokens, "estimated_usd": round(cost, 6)})
本次环境没有可用 API 密钥,示例未在本次任务中实际运行;模型名、价格、推理档位和 Responses API 用法已按 9 月 30 日官方文档核验。价格估算未含工具调用、区域处理、Fast、Batch/Flex 与超长上下文加价,生产账单应以控制台为准。
对开发者的真实影响
具体场景是代码修复 Agent:简单格式修改可以继续走 Luna,跨文件调试走 6.1 Sol,涉及高风险发布或科学推理再升级 Astra。路由不应只看提示词长度,而应看失败代价。一次 0.02 美元但成功率 60% 的调用,可能比一次 0.08 美元、成功率 95% 的调用更贵。
我的判断是,6.1 Sol 会把“默认上最强模型”进一步变成财务上不合理的选择,但也会让团队更容易误把官方平均值当作自己的收益。正确动作是保留旧模型对照,冻结任务集与评分器,统计成功率、P95 延迟、输出 token、缓存命中、回退率和人工分钟数。
边界、风险与检查表
官方明确评测环境可能与生产 ChatGPT 不同,竞品数据也取自公开报告。迁移前应检查:工具 schema 是否兼容;none 和 minimal 推理档位是否被误用(6.1 Sol 不支持);图像任务是否重跑;超过 272K 的请求是否拆分;缓存前缀是否稳定;高风险动作是否仍需确认。先灰度 5%,连续观察失败类别,而不是只看平均分。
你们选模型时最常漏掉哪个成本:失败重试、人工复核,还是缓存未命中?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。