“流式输出”不只是把完整答案切成小块打印。真正可用的接入必须让生成端、网络或进程边界、界面消费端保持节奏,还要在用户点停止时释放任务。读完本文,你会看懂异步流、背压和取消分别解决什么,并能用一个最小程序验证控制链。
最新事件:本地模型也要先证明完整生命周期
Microsoft 社区 9 月 25 日发布 Foundry Local 的 Rust 实践,演示在应用进程内完成模型目录发现、别名解析、下载缓存、加载和 token 流式返回。它强调先做一条最小“探针”,确认目标机器的执行设备与模型生命周期,再嵌入 Rocket 等 Web 框架,而不是一开始就叠加 RAG(检索增强生成)和 Agent。
官方仓库同时说明,Foundry Local 面向单用户端侧应用,可直接用 SDK,也可启动兼容 OpenAI 协议的本地 HTTP 服务;它不是为多用户连续批处理设计的 vLLM 替代品。当前 v2.0.1 又把新应用引向统一 Session API,并保留同步、流式、请求取消与 token 用量等能力。版本迁移和 Rust 包发布状态仍应在安装当天复核。
它解决什么问题
生活类比是一条寿司传送带:厨师持续放盘,顾客持续取盘;顾客吃得慢时,传送带容量会限制厨师继续放,顾客离席时还要通知厨房停单。类比边界是 token 并非独立菜品,模型下一步生成依赖前文状态,取消也可能要等当前计算步结束。
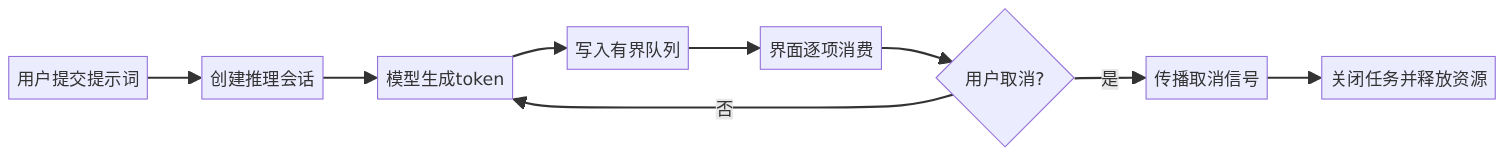
去掉类比,异步流是生产者逐项产生结果、消费者用异步迭代器逐项读取的接口;背压是有界缓冲区把消费速度反馈给生产端;协作式取消则由调用方发出信号,让生产端在安全检查点结束、关闭会话并释放模型或缓存资源。三者缺一,页面“看起来在流式”也可能积压内存或继续占用 NPU、GPU。
最小实践:让慢消费者真正停下来
下面不用任何模型,专门验证控制逻辑。生产者比消费者快,有界队列形成背压;收到 5 个 token 后,消费者取消生产任务。
import asyncio

async def model_stream():
    for token in list("本地模型正在持续生成答案"):
        await asyncio.sleep(0.01)
        yield token

async def run(limit=5):
    queue = asyncio.Queue(maxsize=2)

    async def producer():
        async for token in model_stream():
            await queue.put(token)
        await queue.put(None)

    task = asyncio.create_task(producer())
    received = []
    try:
        while len(received) < limit:
            token = await queue.get()
            if token is None:
                break
            received.append(token)
            print(token, flush=True)
            await asyncio.sleep(0.03)  # 模拟较慢的界面
    finally:
        if not task.done():
            task.cancel()
        try:
            await task
        except asyncio.CancelledError:
            print("producer cancelled")
    return received

tokens = asyncio.run(run())
assert len(tokens) == 5
print("received=", len(tokens))
依赖只有 Python 标准库。保存为 stream_control.py,运行 python stream_control.py。本次在 Python 3.9 实际运行,输出 5 个片段、producer cancelled 和 received= 5,断言通过。真实 SDK 中要把 task.cancel() 换成其会话或请求取消接口,并在 finally 中关闭会话;官方也提醒取消是协作式的,可能要等当前生成步骤完成。
三个常见误区
第一,“前端停止渲染就等于取消”。如果服务端仍在读模型流,算力和内存不会自动归还。第二,“队列越大越平滑”。无界队列只是把慢消费转成延迟和内存债务,应按可接受等待时间定容量。第三,“本地推理没有网络就不需要超时”。模型下载、首次加载、驱动故障和长输出都可能卡住,仍需分别设置启动、首 token 和总时长预算。
适用与不适用
这一模式适合聊天、转写、代码补全等增量结果有价值的交互,也适合在 UI 和本地推理之间隔离速度差。批量离线任务若只关心完整 JSON,流式会增加状态管理;多人高并发服务也不该直接照搬单用户端侧运行时,而应使用具备排队和连续批处理的服务栈。
真正上线时,建议把一次请求拆成四个可观测时间点:进入队列、首 token、最后 token、资源释放完成。用户看到“已停止”之后,后台若又过数秒才释放模型会话,这段差值也应进入告警。错误原因不要只记成 cancelled,至少区分用户主动停止、客户端断开、首 token 超时、总时长超限和运行时异常,否则团队无法判断该调界面、队列还是模型参数。
进程内与本地 HTTP 也不是非此即彼。进程内路径少一道序列化,模型生命周期更容易由应用掌握;独立服务则能隔离崩溃,让多个界面共享模型。选择标准应是故障边界、升级方式和并发需求,而不是“本地一定更快”。无论选哪条路,取消信号都要跨过全部边界,直到实际生成循环。
我的判断是,进程内推理真正省掉的不是几毫秒 HTTP 开销,而是让应用能直接管理模型生命周期;代价是资源释放、崩溃隔离和取消语义也落到应用团队身上。上线前至少记录首 token 延迟、取消后释放时间、队列峰值和错误结束原因。
5分钟实践题
把队列容量从 2 改为 1 和 20,观察输出节奏;再把 limit 改为 3,确认生产任务仍会取消。最后写下你的产品中“点击停止”后,前端、接口层和模型运行时各自应收到什么信号。
你的 AI 应用目前能真正停止模型生成,还是只把界面上的文字隐藏了?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。