
AI 眼镜要理解你几周前听过的话,本地算力和存储很快就不够;把上下文传到普通云端,又意味着平台在处理时可能接触明文。Meta 给出的答案是:设备先验证远端硬件和代码,再发送数据。关键变化是信任对象从“运营商承诺”缩小为芯片证明、公开账本和客户端校验组成的链条。
官方披露了什么
Meta 9 月 23 日介绍用于 AI 眼镜的 Private Processing。官方称,模型在机密虚拟机(CVM)内执行,CPU 和 GPU 的受保护内存对宿主系统、虚拟机管理程序与数据中心管理员保持不可读;需要长期保存的结果,用用户提供的密钥加密后再离开受保护环境。
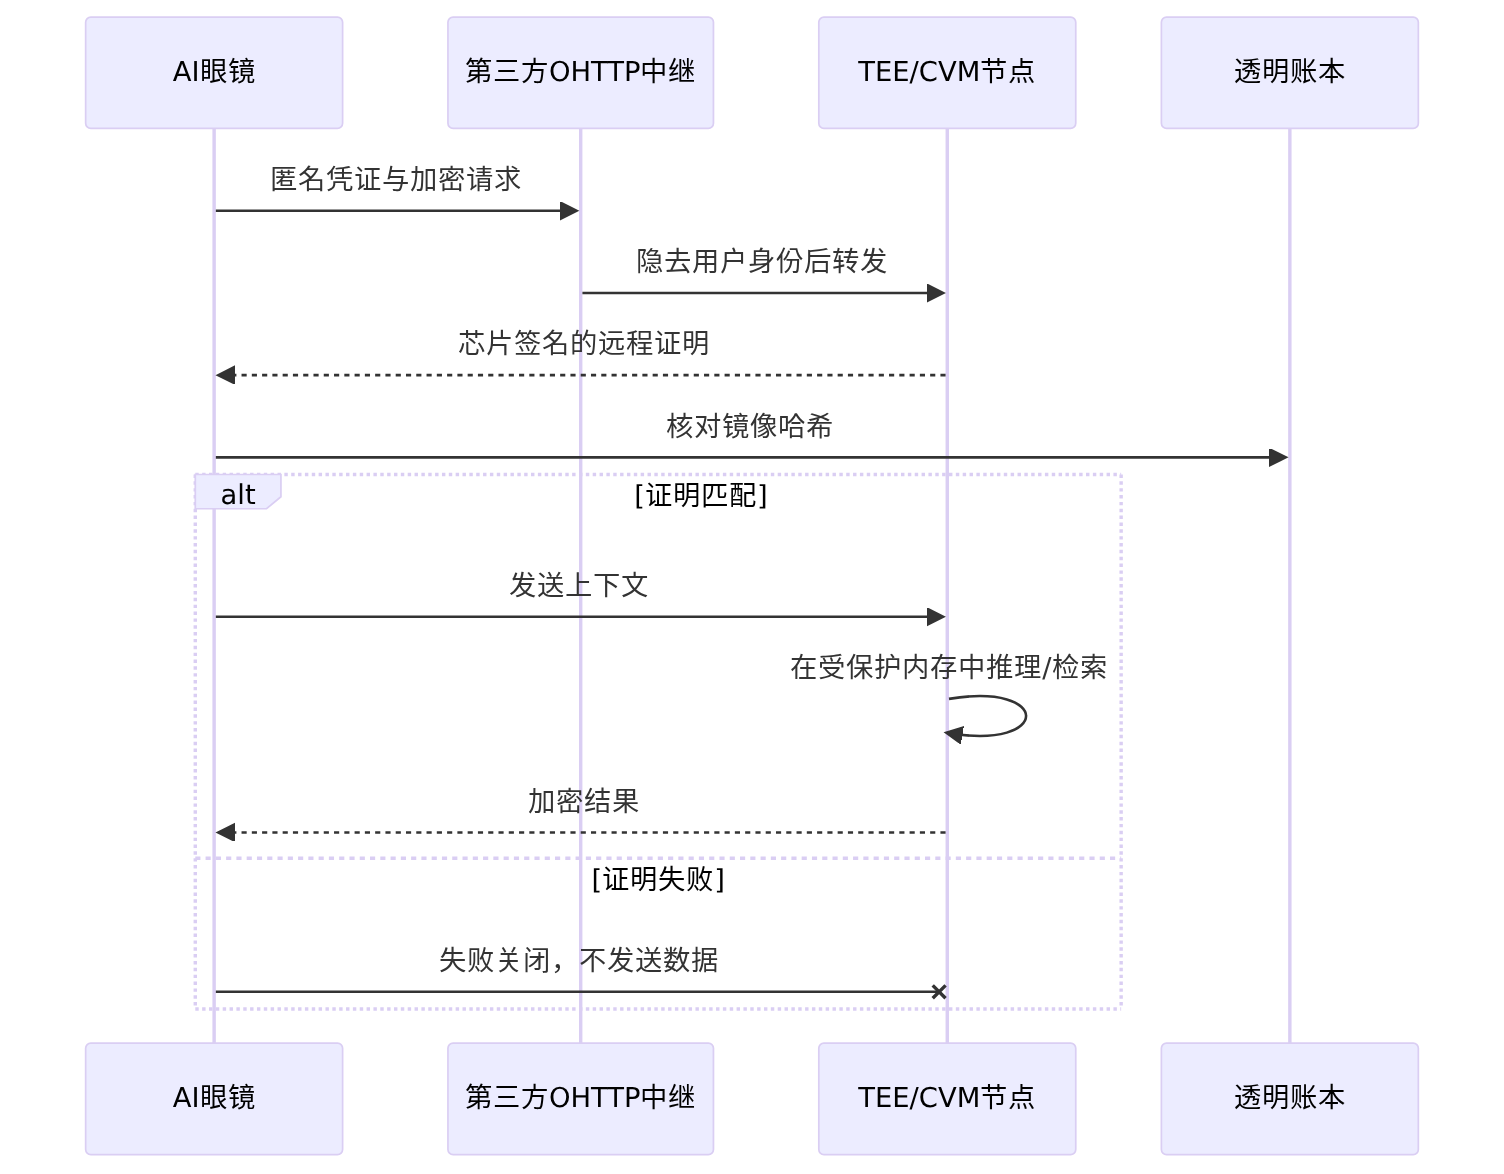
其五项工程要求是硬件隔离、失败关闭、公开可验证、不可定向和加密存储。客户端建立连接时要求远程证明,把服务器加载的软件镜像哈希与第三方见证的追加式透明账本比对;证书或哈希不匹配,就不上传上下文。
技术原理:保护“使用中”的数据
传统加密主要覆盖传输中和静态存储。模型推理时,数据仍要在内存里变成可计算形式。可信执行环境(Trusted Execution Environment,TEE)利用硬件隔离和内存加密,把宿主操作系统也排除在信任边界之外。
远程证明不是“服务器说自己安全”,而是芯片对当前硬件与软件测量值签名。客户端验证证书链、镜像哈希和允许列表,才建立会话。不可定向路由则试图解决另一个问题:即使节点安全,运营者若知道请求属于谁,仍可能把特定用户导向恶意节点。官方方案使用盲签名匿名凭证与 Fastly 或 Cloudflare 的 OHTTP 中继,减少身份和处理节点之间的关联。
最小实践:实现失败关闭的证明策略
真实远程证明涉及芯片厂商证书和 TLS 扩展,下面只演示客户端决策逻辑,不产生真实安全保证。
import hashlib

approved_images = {
    "v17": "d7a37c1cb3fe30f4f8cb0f5e738c9b30d6f3de7d2aa1e1a8b891e98d14b9f19b"
}

def verify_attestation(report):
    if not report.get("vendor_signature_valid"):
        return False, "芯片签名无效"
    version = report.get("image_version")
    expected = approved_images.get(version)
    if expected is None:
        return False, "镜像版本未获批准"
    measured = hashlib.sha256(report["image_bytes"]).hexdigest()
    if measured != expected:
        return False, "镜像哈希不匹配"
    return True, "允许发送"

report = {
    "vendor_signature_valid": True,
    "image_version": "v17",
    "image_bytes": b"private-ai-runtime-v17",
}
ok, reason = verify_attestation(report)
print(ok, reason)
assert ok is False  # 示例允许列表故意与镜像不匹配
无需第三方依赖,运行 python attest_gate.py。本次在 Python 3.9 实际运行,哈希不匹配时返回 False,断言通过。生产系统绝不能用自制 JSON 代替硬件证明,也不能把允许列表从同一个未验证服务器临时下载。
它仍然不能解决什么
第一,TEE 不能保证模型输出一定正确,也不能阻止用户自己授权了过多数据。第二,访问模式可能泄露行为;Meta 因此把存储引擎放进 TEE,但流量时间、设备侧日志和产品层遥测仍需单独审计。第三,机密环境让运维更难:工程师不能附加调试器、转储内存或查看触发故障的输入,只能依赖 CPU、内存和延迟等聚合信号。
官方还称镜像记录公开可见、对应二进制向安全计划下的研究者开放,并接受第三方审计。这里的边界是“可发现未登记的二进制替换”,不等于所有实现缺陷都已被证明不存在。该架构尚缺公开的规模化延迟、误拒绝率和长期运营数据,不能把设计说明当成独立安全认证。
真正需要审计的是整条信任链
硬件证明只覆盖被测量的那份代码正在指定隔离环境里运行。它不会自动证明编译器、依赖包、模型权重和更新流程没有问题。因此部署方还要回答:镜像如何构建,谁能批准新哈希,旧版本何时撤销,芯片厂商根证书泄露后如何恢复,客户端允许列表多久更新一次。
密钥路径同样不能省略。若所谓“用户提供的密钥”最终由平台账户服务单独恢复,平台仍可能在特定条件下重建访问能力;若完全由设备持有,换机和丢失设备又会带来恢复难题。产品应明确密钥是否跨设备同步、谁能触发恢复、恢复事件是否通知用户,而不是只写“端到端加密”。
对开发团队,最现实的代价是可观测性下降。常规故障排查会查看请求、堆栈和模型输出,在 TEE 中这些信息恰恰不该暴露。工程上要提前设计隐私预算内的聚合计数、阶段性错误码、可重复的合成请求和客户端自愿上传诊断包;否则系统安全了,却可能在大规模故障时无法定位问题。
最后还要测试降级路线。证明服务不可用时,应停止敏感云端处理,还是退回本地小模型?网络断开时,哪些记忆可在设备侧继续使用?“失败关闭”若只意味着功能全部消失,用户可能为了可用性主动关闭安全校验。好的设计应让安全降级可预期,而不是逼用户在隐私和功能之间临时二选一。
对开发者和用户的建议
开发者评估类似服务时,应要求威胁模型、证明验证路径、失败模式、密钥归属、二进制透明度与独立审计,而不只问“是否加密”。用户则应关注哪些功能必须上云、记忆保存多久、能否查看和删除,以及关闭云端记忆后功能如何降级。
我的判断是,可穿戴 AI 的隐私竞争会从“数据是否上传”转为“上传后谁能证明自己看不见”。但再强的 TEE 也不能替代最小化采集;最安全的数据仍是没有被记录的数据。
如果 AI 眼镜能持续记忆,你最希望默认关闭哪一类数据的云端处理?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。