AI 说“根据账户记录,你有 30 天退款期”,这句话可能事实正确,引用却错了:30 天来自通用政策,账户记录里根本没有。读完本文,你会理解多源 RAG 为什么要保留来源身份,并能用一段 Python 检查“每个声明是否真的由它声称的来源支持”。
最新事件:事实正确,也可能没有通过验证
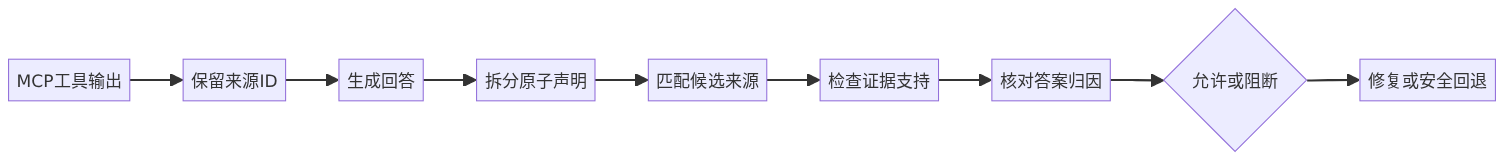
Multiverse Computing 团队 9 月 29 日介绍了 ProvenanceGuard。它面向通过 MCP(Model Context Protocol,模型上下文协议)调用多个工具的 Agent,在答案生成后读取完整工具轨迹,把回答拆成声明,再逐条寻找支持来源、检查证据和归因,最后允许、阻断或进入修复。
团队报告的医学场景测试包含 281 条真实轨迹;在留出的 40 个回答、361 个声明中,专家认为 139 条不该通过,系统拦下 138 条,同时也把 67 条专家认为有支持的声明送去复核。这个结果说明它偏保守,也说明“拦得多”不等于“判断完美”。相似来源压力测试里,精确找对来源的比例只有 50.3%,边界必须说清。
它解决什么问题
把多源 RAG 想成写论文:图书馆里确实有一句话,不代表你能把它脚注到任意一本书。类比的边界是,真实 Agent 的来源不只是文档,还可能是数据库记录、搜索结果、API 返回和用户私密数据;这些来源的权限、时效和可信等级并不相同。
去掉类比,来源感知验证是维护“声明—证据—来源标识”的映射,而不是先把所有工具输出拼成匿名上下文,再只问句子是否有支持。它要同时回答三个问题:声明是什么、哪份原始输出支持它、回答明示或暗示的来源是否与支持来源一致。
最小实践:抓住“事实对、出处错”
下面的教学版不用模型,只用关键词交集展示核心数据结构。生产系统应换成嵌入检索和自然语言推断(NLI),但仍要保留来源 ID。
import re

sources = {
    "account": "用户方案为专业版,账户状态正常。",
    "policy": "专业版购买后30天内可以申请退款。",
}
claims = [
    {"text": "用户是专业版", "named_source": "account"},
    {"text": "退款窗口是30天", "named_source": "account"},
]

def tokens(text):
    return set(re.findall(r"[\u4e00-\u9fff]+|\d+", text))

def support_score(claim, source):
    ct = tokens(claim)
    st = tokens(source)
    numbers_ok = re.findall(r"\d+", claim) == re.findall(r"\d+", source)
    overlap = len(ct & st) / max(1, len(ct))
    return overlap + (0.5 if numbers_ok else -1.0)

for item in claims:
    ranked = sorted(
        sources,
        key=lambda sid: support_score(item["text"], sources[sid]),
        reverse=True,
    )
    best = ranked[0]
    verdict = "ALLOW" if best == item["named_source"] else "BLOCK"
    print(item["text"], "support=", best, "verdict=", verdict)

assert support_score("退款窗口是30天", sources["policy"]) > 0
assert claims[1]["named_source"] != "policy"
无需第三方依赖,保存为 provenance_gate.py,运行 python provenance_gate.py。本次在 Python 3.9.6 实际运行,第二条声明被识别为应由 policy 支持,因此对错误标注的 account 归因执行阻断。它只验证流程,不复现论文模型与医学数据结果。
常见误区
第一,认为有 URL 就有证据。链接可能只与主题相关,并不支持具体数字。第二,把所有工具结果合并后做一次“忠实度”评分;这样会丢掉来源身份。第三,把来源匹配当成真实性证明;原始来源本身也可能过期或错误。第四,见到 138/139 就认为可以无人审核;论文同时出现明显的保守误拦与相似来源识别下降。
适用与不适用
它适合医疗、金融、客服、合规研究等需要解释“依据来自哪里”的多工具工作流,也适合把引用检查变成发布门禁。不适合只靠这一层解决知识库污染、恶意工具输出和权限越界;来源感知不是内容可信、授权合法和数据新鲜的替代品。
我的判断是,多源 RAG 的下一个基础设施不是更长上下文,而是可追溯的证据链。开发者应从数据结构开始改:每段工具输出带不可变来源 ID、采集时间和权限域;每个回答声明保存候选证据与判定,而不是只留下最终文本。
5分钟实践题
给 sources 增加一份同样包含“30天”、但描述试用期的文档,观察简单关键词为何会选错。然后为来源增加 document_type,规定退款声明只能由政策类文档支持。
你的 RAG 验收现在只检查答案正确,还是也能指出每句话究竟来自哪个数据源?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。