
机器人训练失败,很多人第一反应是换更大的模型。更常见的真相却是:摄像头画面和动作错了几帧、失败片段被当成成功样本,或同一房间的数据同时进了训练集和验证集。读完这篇,你会知道“数据质量”到底检查什么,并用一段纯 Python 脚本先抓住最常见的时序问题。
最新事件:训练表也可以是搜索索引
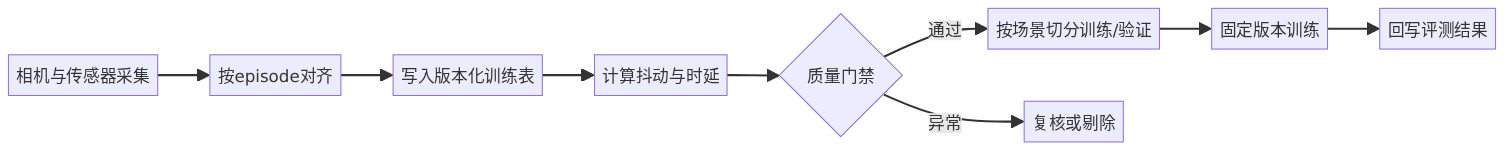
Hugging Face 社区在 9 月 24 日发布 LeRobot 与 LanceDB 的集成实践。官方文章显示,LeRobotDataset 可以直接读取 Lance 表,从对象存储按批取数、全局打乱,还能把视觉向量、动作粗糙度、成功标记等放在同一张版本化表中。训练器读取的版本与分析人员搜索的版本因此可以一致。
文章给出的 DROID 实验包含 2763 万帧、95658 个 episode(一次完整任务轨迹)和 369GB 视频。相同采样顺序下,远程 LanceDB 方案的稳定吞吐为每秒 495 个样本,本地 NVMe 读取为 361;但这是特定的 8×H100、缓存与数据布局结果,不等于所有云存储都会更快。
它解决的不是“存在哪”,而是“训练了哪一份”
生活类比是厨房备菜:食材放进更大的冰箱并不会自动变新鲜。真正有用的是每盒食材有批次、质检结果和去向,厨师能复现昨天那道菜用了哪一批。
类比的边界是,训练样本之间存在时间依赖,不能像土豆一样随意交换。准确地说,数据版本化是把原始媒体、状态、动作、派生特征、筛选条件和版本标识绑定,让同一个查询在固定版本上得到同一批样本;数据质量则判断这些样本是否与任务语义、时间和评测边界一致。
最小实践:先找动作时延和异常抖动
下面用合成数据演示两个检查:相邻动作变化是否过猛,以及观测与动作在哪个时移下最匹配。它不是 LeRobot 或 LanceDB 的替代品,而是可以嵌入数据回填任务的最小质量函数。
from statistics import mean

observations = [0.0, 0.2, 0.5, 0.9, 1.2, 1.4, 1.5]
actions =      [9.9, 0.0, 0.2, 0.5, 0.9, 1.2, 1.4, 1.5]
noisy_actions = [0.0, 0.0, 0.2, 0.5, 0.9, 1.2, 2.9]

def mse_at_lag(obs, act, lag):
    pairs = [(obs[i], act[i + lag])
             for i in range(min(len(obs), len(act) - lag))]
    return mean((x - y) ** 2 for x, y in pairs)

def best_lag(obs, act, max_lag=3):
    scores = {lag: mse_at_lag(obs, act, lag)
              for lag in range(max_lag + 1)}
    return min(scores, key=scores.get), scores

def jerk_score(act):
    velocity = [b - a for a, b in zip(act, act[1:])]
    acceleration = [b - a for a, b in zip(velocity, velocity[1:])]
    return max(abs(x) for x in acceleration)

lag, scores = best_lag(observations, actions)
print("best_lag=", lag, "scores=", scores)
print("jerk_score=", round(jerk_score(noisy_actions), 3))
assert lag == 1
assert jerk_score(noisy_actions) > 1.0
依赖只有 Python 标准库。保存为 quality_check.py 后运行 python quality_check.py。本次在 Python 3.9 实际运行,最佳时移为 1,抖动分数为 1.4,两条断言通过。关键不是阈值 1.0,而是先用真实设备的正常轨迹建立分布,再把异常样本送人工复核。
三个常见误区
第一,“全局随机打乱就不会泄漏”。若同一住宅、操作者或连续录像被拆到两边,验证集仍可能泄漏。应优先按地点、人员或采集批次分组切分。
第二,“越平滑的数据越好”。官方实践在 DROID 上发现,成功 episode 反而更抖;单一平滑度指标的 AUROC 只有 0.402。质量分数必须结合任务语义,不能直接当真值。
第三,“固定随机种子就能复现”。种子固定但底层数据版本、筛选查询或视频解码器变了,结果仍会漂。复现需要同时固定数据快照、代码提交、模型与采样顺序。
适用与不适用
这套方法适合多相机、动作序列、日志量大的机器人或具身智能训练,也适合任何需要反复筛选的时序数据。小型静态分类任务未必需要数据库化;强实时闭环控制也不能把在线安全检查交给离线查询系统。
一份可落地的数据契约
若要把概念变成工程动作,可以先为每个 episode 固定六类字段:采集地点与设备、操作者或机器人编号、任务指令、开始结束时间、成功定义、原始文件哈希。派生的抖动、时延、视觉向量和质量标签必须记录计算代码版本,不能覆盖原始值。训练任务则额外保存数据快照编号、筛选查询和排除原因。
质检也要分两层。自动层检查缺帧、时间戳倒退、动作越界、相机数量和字段类型;人工层抽看模型最难、指标最异常和随机采样的轨迹。前者保证数据“能读”,后者判断动作是否真的完成了指令。若只做自动检查,一个格式完美却把杯子放错桌面的 episode 仍会混进训练集。
切分时不要先随机再补标签,而应先选择不会跨集合的分组键。例如家庭机器人按房屋切分,仓储机器人按站点和日期切分,个人助理按用户切分。最后再检查训练、验证两边是否共享视频哈希、连续时间段或高度相似的图像。这个顺序比事后追查虚高指标便宜得多。
我的判断是,LeRobot×LanceDB 更重要的意义不是“对象存储比 NVMe 快”,而是把训练、搜索与质检指向同一份可固定版本的数据。工程团队应先建立数据契约和复核门禁,再谈吞吐提升。
5分钟实践题
把 noisy_actions 最后一个动作从 2.9 改成 1.4,观察抖动分数;再把延时动作整体向后移动两格,检查 best_lag 是否变化。然后写下你的真实项目应按“用户、设备、地点、日期”中的哪一项分组切分。
你的训练项目里,最容易被忽略的是标签错误、时序错位,还是切分泄漏?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。