
GitHub 让 Agentic Autofix 开始读取 Copilot Memory,并把成功修复模式留给后续安全告警。它能减少同类漏洞反复解释,却也把风险从“这次补丁对不对”扩大到“被复用的经验是否仍然正确”。对开发团队而言,真正要建设的是可验证的安全规则库,而不是越长越好的记忆。
发生了什么
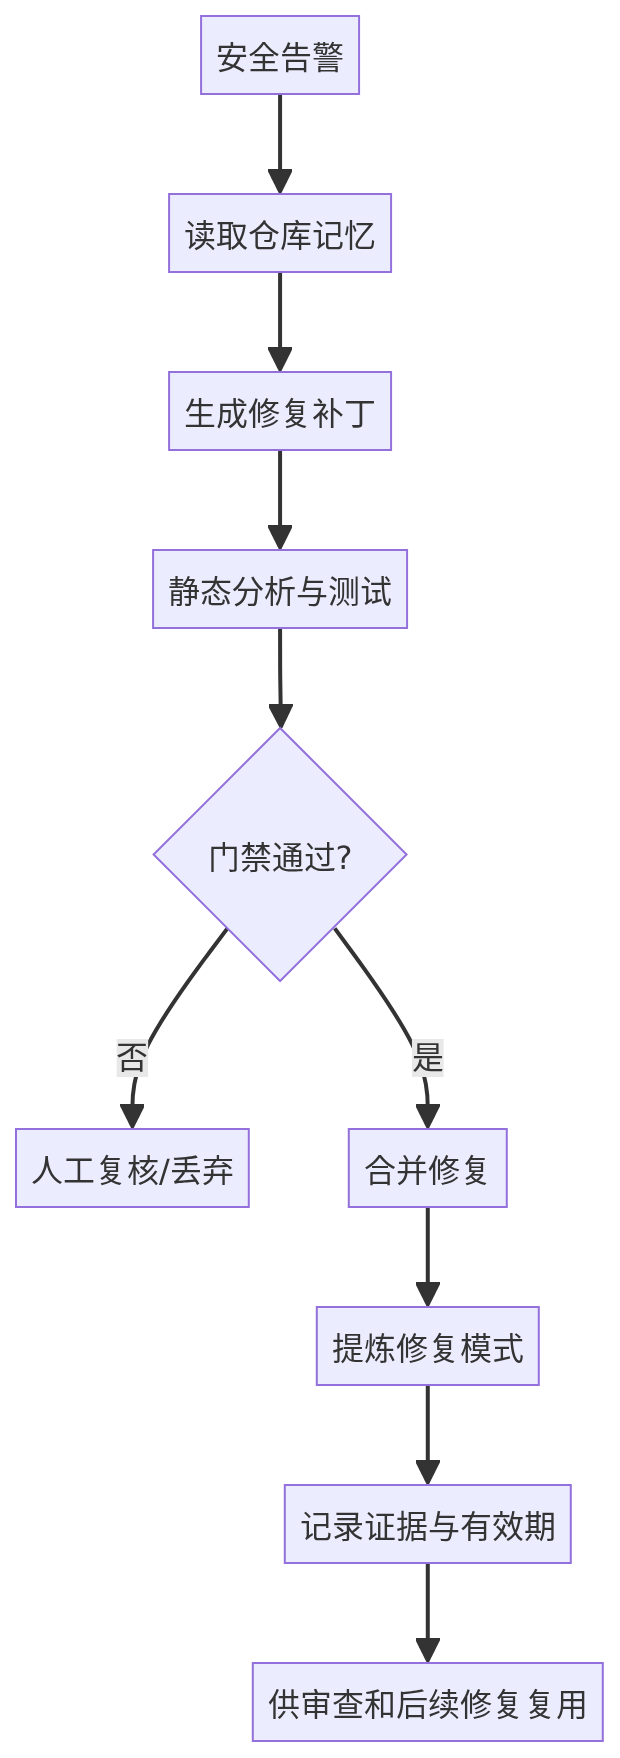
GitHub 9 月 25 日公告称,启用 Copilot Memory 的客户在使用 Agentic Autofix 时,系统会读取已有记忆辅助解决安全告警;创建修复后,还会保存修复模式,供以后处理相似告警,并可被代码审查、云端 Agent 等功能使用。Agentic Autofix 与 Copilot Memory 目前都处于公开预览。
官方文档把记忆分为两类:仓库级事实包括编码约定、架构决策、构建命令和项目规则;用户级偏好只服务个人交互。安全修复主要依赖仓库级事实。跨功能复用是这次变化的价值,也是影响半径变大的原因。
记忆为什么能提高修复质量
漏洞修复很少只有“把危险函数换掉”这么简单。一个仓库可能要求所有数据库访问经过特定封装、两个配置文件必须同步修改,或某个输入在上游已做规范化。通用模型不知道这些局部事实,容易生成能通过单测、却破坏项目边界的补丁。
记忆把局部约束带进下一次推理,相当于给新来的安全工程师一份经过整理的值班手册。我的核心判断是:记忆的单位应是“规则+证据+失效条件”,不能只保存一段自然语言结论。代码、依赖和威胁模型都会变化;没有来源与有效期的旧经验,可能把已修复的模式重新引入。
最小实践:让记忆先过门禁
下面的纯 Python 示例只演示治理逻辑:规则必须带来源提交、测试名和到期日;过期或未被当前测试集覆盖的记忆不会进入提示上下文。
from datetime import date

memories = [
    {"rule": "SQL必须参数化", "source": "a1b2c3d",
     "test": "test_sql_injection", "expires": "2026-12-31"},
    {"rule": "JWT允许HS256", "source": "old777",
     "test": "test_jwt_policy", "expires": "2026-06-30"},
]

passing_tests = {"test_sql_injection", "test_path_traversal"}

def approved_memory(item, today):
    expiry = date.fromisoformat(item["expires"])
    has_evidence = len(item["source"]) >= 7
    test_is_green = item["test"] in passing_tests
    return has_evidence and test_is_green and expiry >= today

usable = [m for m in memories
          if approved_memory(m, date(2026, 9, 27))]

for item in usable:
    print(f"USE: {item['rule']} ({item['source']})")

assert [m["rule"] for m in usable] == ["SQL必须参数化"]
无需第三方依赖,保存后运行 python memory_gate.py。本次在 Python 3.9 实际运行,只有“SQL 必须参数化”通过,断言成功。真实系统还应验证提交签名、规则适用目录、依赖版本和测试结果来源。
对团队的具体影响
场景一:仓库曾多次把数据库查询改成参数化调用。记忆能提醒 Autofix 使用项目自己的查询封装,同时让代码审查发现绕过封装的新代码。
场景二:一次临时兼容补丁允许旧哈希算法。如果它被无期限保存,未来 Agent 可能把“临时例外”当成最佳实践。此时有效期和目录范围比记忆文本本身更重要。
场景三:攻击者通过文档或代码注释植入伪规则。只让已合并补丁、受保护分支和通过安全测试的结论进入记忆,可以缩小投毒面,但不能完全消除它。
边界与风险
官方没有在这则公告中披露记忆检索排序、冲突消解和误用率,因此不能据此声称 Autofix 的漏洞修复率已经提高。预览功能也可能改变保存与管理方式。记忆不应覆盖 CodeQL、单元测试、依赖扫描或人工审查;高风险身份认证、加密和权限变更仍应强制人工批准。
记忆也需要完整生命周期
一条修复经验进入共享层前,至少应经历“提出、验证、批准、使用、复查、撤销”六个状态。提出阶段保留告警类型、受影响路径和补丁链接;验证阶段绑定能在旧代码上失败、在新代码上通过的回归测试;批准阶段由代码所有者确认适用范围。后续每次使用都记录命中了哪条规则、是否被开发者采纳,以及最终测试结果。
撤销能力尤其重要。假设仓库从自建会话迁移到托管身份,过去关于 Cookie 的安全模式就可能不再适用。系统应该先标记为停用,再观察新补丁是否仍引用它,而不是直接删除痕迹。若两条记忆冲突,应按目录范围、依赖版本和最近验证时间选择,无法消解时退回人工审查。
还要区分“事实”和“建议”。“构建命令是 make test”可以自动验证;“所有外部请求都重试三次”包含架构取舍,可能放大支付等非幂等操作,不能因为在一次修复中有效就升级为全仓库规则。把置信度和适用前提写进结构化字段,比让 Agent 自己从一段长文字猜边界可靠。
落地时可先做四件事:把记忆限定在仓库级;要求每条规则链接到修复 PR 与回归测试;设置责任人和失效日期;每次依赖大版本升级后重跑记忆对应的测试。若无法回答“谁证明过、在哪适用、何时失效”,就不该让它自动影响补丁。
我的判断是,安全 Agent 的竞争力会从单次生成能力,转向组织能否维护一套可审计、可撤销的经验层。记住得多不等于更安全,记得有证据才是。
你更愿意让 AI 自动保存哪些修复经验,又会禁止它记住什么?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。