
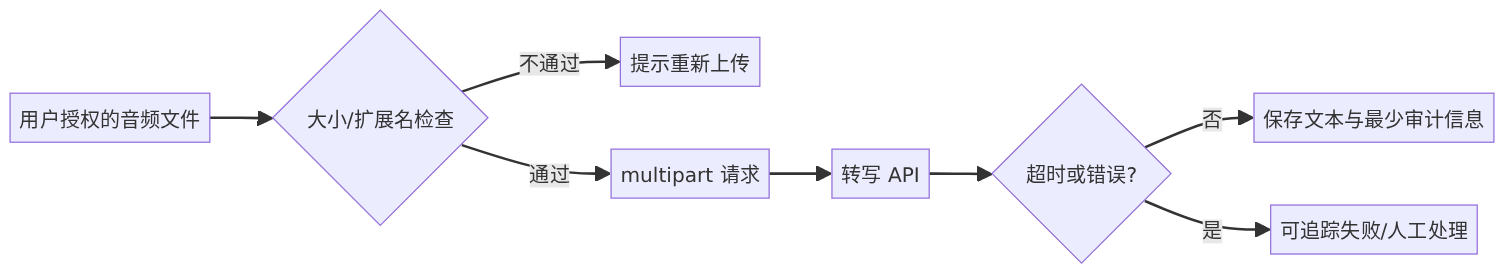
把会议录音交给语音识别模型,最容易忽略的不是“识别准不准”,而是输入与故障:文件可能为空、格式不支持、网络长时间无响应,或录音本身含个人信息。一个入门但可复用的转写入口应该先拒绝明显错误,再给网络请求时间上限,并把失败变成可处理的状态。本文用 Python 标准库演示 multipart 上传;你可以把它接到上传页面、定时任务或客服质检流程。
语音识别(Automatic Speech Recognition,ASR)会把音频波形转换为文本。模型负责听写,应用仍须负责文件白名单、上传授权、重试策略和文本后处理。官方 Speech-to-Text 文档列出音频转写能力与接口;请在部署时以账号控制台和最新文档确认模型 ID、大小限制、价格及数据政策。
环境与运行
Python 3.10+ 无第三方依赖。只在有录音所有者授权的前提下使用;示例不上传任何本地文件。
export OPENAI_API_KEY='你的密钥'
python3 transcribe.py meeting.mp3
完整代码
本例构造 multipart 请求并将总请求限制为 45 秒。为让代码聚焦流程,使用当前官方转写文档中的 gpt-4o-transcribe 作为示例模型;接口或权限变化时应以官方文档为准。
import json, mimetypes, os, pathlib, sys, uuid
import urllib.error, urllib.request

MAX_BYTES = 20 * 1024 * 1024
def part(boundary, name, value, filename=None, content_type=None):
    head = f"--{boundary}\\r\\nContent-Disposition: form-data; name=\\\"{name}\\\""
    if filename: head += f"; filename=\\\"{filename}\\\"\\r\\nContent-Type: {content_type}"
    return head.encode() + b"\\r\\n\\r\\n" + (value if isinstance(value, bytes) else value.encode()) + b"\\r\\n"

def transcribe(path: pathlib.Path):
    key = os.getenv("OPENAI_API_KEY")
    if not key: raise RuntimeError("缺少 OPENAI_API_KEY")
    if not path.is_file() or path.stat().st_size == 0 or path.stat().st_size > MAX_BYTES:
        raise ValueError("文件不存在、为空或超过教学上限 20MB")
    mime = mimetypes.guess_type(path.name)[0] or "application/octet-stream"
    if mime not in {"audio/mpeg", "audio/wav", "audio/mp4", "audio/x-m4a"}:
        raise ValueError("请使用 mp3、wav、m4a 或 mp4 音频")
    boundary = "----snail" + uuid.uuid4().hex
    data = part(boundary, "model", "gpt-4o-transcribe")
    data += part(boundary, "file", path.read_bytes(), path.name, mime)
    data += f"--{boundary}--\\r\\n".encode()
    req = urllib.request.Request("https://api.openai.com/v1/audio/transcriptions", data=data,
        headers={"Authorization": "Bearer " + key, "Content-Type": "multipart/form-data; boundary=" + boundary})
    with urllib.request.urlopen(req, timeout=45) as resp:
        if resp.status != 200: raise RuntimeError(f"HTTP {resp.status}")
        return json.load(resp)["text"]

if __name__ == "__main__":
    try: print(transcribe(pathlib.Path(sys.argv[1])))
    except (IndexError, ValueError, RuntimeError, urllib.error.URLError, TimeoutError) as e:
        print(f"TRANSCRIBE_FAILED: {e}", file=sys.stderr); raise SystemExit(2)
如何理解输出与失败
成功时标准输出是一段文本;失败时进程返回码为 2,并以 TRANSCRIBE_FAILED 开头,便于任务队列识别。mimetypes 只是初筛,恶意上传仍可能伪装扩展名,生产环境还应检测文件头、扫描恶意文件。45 秒并不是最佳值:短音频可更短,长音频应采用拆分、异步任务与可取消状态,而不是无止境等待。
本次用 python3 -m py_compile transcribe.py 完成语法检查,未设置真实密钥、未上传或调用线上 API。常见失败包括:一,密钥权限或余额不足;二,音频编码与扩展名不符;三,网络代理导致超时。分别处理为:不记录密钥、用音频工具规范化编码、将超时任务标为可重试并设置最大次数。
何时采用与如何工程化
适合会议纪要初稿、客服质检、用户明确授权的访谈检索;不适合把未审阅文本当法律、医疗或人事结论。下一步可增加说话人分离、术语表、敏感信息打码、对象存储临时链接和删除策略。五分钟实践:给代码加一个 --dry-run 参数,只打印文件大小与 MIME 类型,确保 CI 不会意外把测试音频传上云。
语音转写失败时,你会优先重试、拆分音频还是转人工?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。