
本地模型开发过去常有一道割裂:用llama.cpp跑GGUF,省内存、速度快;回到Transformers做激活分析、评测或自定义解码,又要换权重和工具链。Hugging Face的新接入把同一份GGUF带进熟悉的Python接口,但它解决的是兼容与复用,不是宣布Transformers全面取代专用推理引擎。
发生了什么
Hugging Face在9月22日宣布,最新Transformers可直接加载并高效运行GGUF量化模型。官方当前示例使用unsloth/Qwen3.5-4B-GGUF的Q4_K_M文件,在Apple Silicon上复用ggml的Metal内核,并优化generate中的CPU—GPU同步。来源为Hugging Face技术文章与文中对应的代码更新。
官方给出的4B模型文件大小很直观:BF16为8.42GB,Q6_K为3.53GB,Q5_K_M为3.14GB,Q4_K_M为2.74GB。官方建议通常从Q4_K_M起步,再按可用内存与任务质量尝试更高精度;这不是“4位一定够用”的保证。
技术原理:格式、权重与运行时是三层
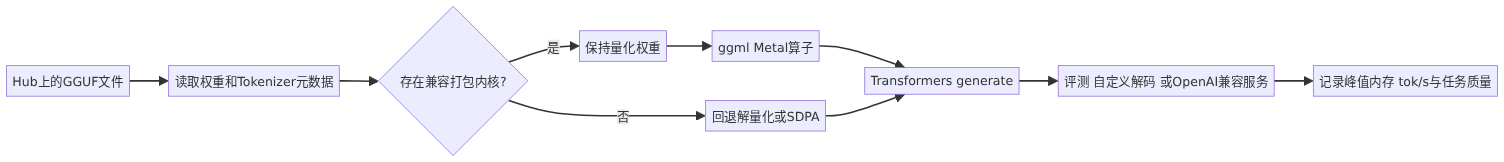
GGUF是一种把权重、Tokenizer元数据和可选聊天模板放进同一文件的格式。Q4_K_M大体以4位保存多数张量,同时给敏感张量更高精度。文件变小只说明存储和读取的权重更紧凑;要跑得快,还要有能直接读取打包权重的矩阵乘内核,以及不频繁等待GPU的生成循环。
新路径通过kernels库调用ggml的量化、归一化、注意力和Gated Delta Network等Metal内核。若兼容内核取不到,加载器可能回退到解量化并用sdpa,内存占用就会明显上升。因此“成功加载”与“仍以打包量化路径高效运行”必须分别验证。
最小实践:先验证路径,再谈性能
当前官方要求Apple Silicon、兼容的PyTorch版本,并暂时从Transformers主分支安装:
pip install -U "git+https://github.com/huggingface/transformers.git" kernels
import time
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL = "unsloth/Qwen3.5-4B-GGUF"
FILE = "Qwen3.5-4B-Q4_K_M.gguf"

tokenizer = AutoTokenizer.from_pretrained(MODEL, gguf_file=FILE)
model = AutoModelForCausalLM.from_pretrained(MODEL, gguf_file=FILE)
inputs = tokenizer(
    "用三句话解释为什么量化会节省内存。",
    return_tensors="pt",
).to(model.device)

with torch.inference_mode():
    model.generate(**inputs, max_new_tokens=8, min_new_tokens=8, do_sample=False)
    torch.mps.synchronize()
    started = time.perf_counter()
    output = model.generate(
        **inputs, max_new_tokens=128, min_new_tokens=128, do_sample=False
    )
    torch.mps.synchronize()

seconds = time.perf_counter() - started
print(f"decode+prefill: {128 / seconds:.1f} tok/s")
print(tokenizer.decode(output[0], skip_special_tokens=True))
代码先预热,再同步MPS并计时;它保留了官方接口,但这个数包含预填充,不能直接与llama-bench -p 0 -n 128的纯解码指标比较。示例未在本次任务中实际运行:需要下载约2.74GB模型并匹配Apple Silicon、PyTorch与预览内核版本。本次仅完成Python静态语法检查,不虚构吞吐结果。
若要提供本地OpenAI兼容端点,官方当前命令为transformers serve "unsloth/Qwen3.5-4B-GGUF:Qwen3.5-4B-Q4_K_M.gguf"。模型参数用“仓库:文件名”明确选定量化文件。
对开发者的实际影响
最直接的收益不是多一个聊天界面,而是同一份GGUF可以进入Transformers生态:复用评测脚本、观察中间激活、修改前向过程、添加Logits Processor,或检查转换误差。对模型研究和本地工具开发,这减少了“推理一套、分析另一套”的资产复制。
但llama.cpp仍是官方推荐的高效本地推理引擎。首批打包路径只覆盖MPS,重点是Qwen3.5稠密与混合专家架构,并兼容部分Qwen3.8检查点;Padding和批处理仍待改进。服务器端CUDA、多并发和其他架构不能从这次发布自动推导。
基准为什么不能只抄一个tok/s
官方对比已经写出一个常被忽略的差异:llama-bench用-p 0排除了Prompt处理,只测128个Token的解码;Transformers示例则从12个Token的输入开始,测量里包含预填充。两根柱子即使接近,也不是严格同条件竞赛。机器还是M2 Max、32GB统一内存、macOS 26.6,并固定PyTorch 2.12.1和kernels 0.17.0。换成普通M系列、不同散热状态或更长上下文,结论都可能变化。
一个更公平的本地评测应分开记录TTFT(Time to First Token,首Token时间)与解码速度。短问答更在意启动和首Token;长生成才更受持续解码速度影响。官方脚本每轮之间休息90秒,因为背靠背运行会因温度让速度下降10%以上。这提醒我们:笔记本跑分不记录电源、温度和预热次数,数字看起来精确,比较却未必有效。
质量评测同样不能省。Q4_K_M在常见聊天上自然,不代表代码补全、数学符号或结构化JSON保持同样稳定。应固定一组真实提示,对不同量化逐条检查任务成功率;如果更小模型需要更多重试,节省的内存可能被时间和人工成本吃回去。
还要把模型下载时间与磁盘空间纳入首次体验,避免只报告热缓存下的速度。
我的判断与行动清单
这次变化的价值是工具链收敛,而不是跑分冠军换人。 GGUF负责可携带的量化资产,ggml内核负责重计算,Transformers负责可编程模型接口。三层组合让本地模型更容易进入研究与评测流程。
落地前做四件事:锁定Git提交与内核版本;记录是否发生回退;同时测峰值内存、首Token时间和稳定解码速度;用自己的代码、中文问答或结构化输出集比较Q4、Q5和BF16质量。只看文件大小或一段顺滑输出,都不足以决定生产选型。
适合它的,是单用户本地实验、量化质量评估和自定义Python推理;不适合直接据此承诺跨平台、批量服务或与llama.cpp完全等价的吞吐。
你更希望用GGUF解决“模型装得下”,还是“模型能被现有Python评测链直接使用”?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。