
数据科学项目最危险的环节,常常不是模型训练,而是工具切换:SQL结果复制进本地,R里做的检查没有进入Python管线,部署参数留在终端历史,报告又手工抄一遍指标。把工具放进同一工作区的价值,不是少开几个窗口,而是让数据、代码、身份和证据沿一条链流动。
发生了什么
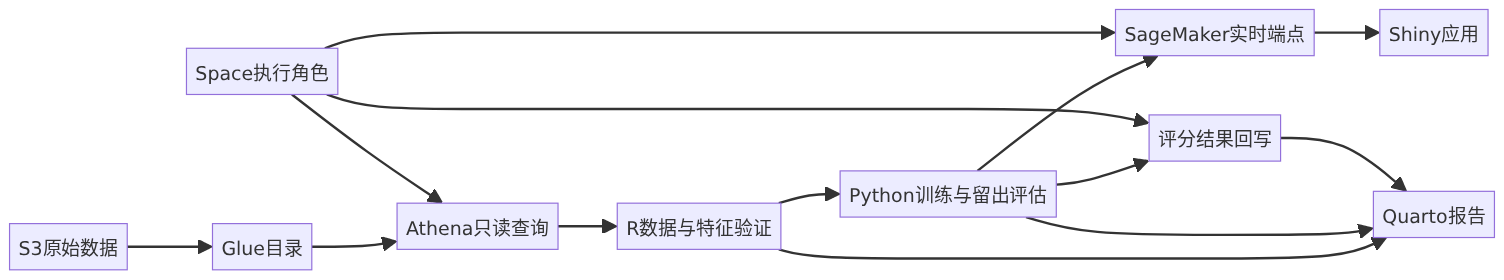
AWS在9月21日展示Positron运行于Amazon SageMaker AI的技术流程。管理员把Posit发布的容器定义构建到私有ECR并挂到Studio域;数据科学家在Space中查询Athena,用R验证特征,用Python训练XGBoost,部署实时端点,再用Shiny调用、用Quarto生成报告。来源为AWS官方技术文章。
演示使用5万条合成贷款数据。官方记录的单次运行中,样例查询扫描2.18MiB且不足一秒;模型在留出集上的AUC为0.834,写回48,500条评分记录并成功调用实时端点。值得注意的是,AWS主动声明这些数字不证明公平性、校准、生产延迟、负载能力或监管合规。
技术原理:统一的是运行上下文,不是语言
Positron仍然让R和Python各做擅长的工作。真正统一的是SageMaker Space执行角色、项目文件、网络入口和产物位置。Athena、Glue和S3访问继承执行角色,不必在代码中保存长期密钥;Shiny应用也通过Studio代理和角色调用指定端点。
这带来两种可复现性。计算可复现性要求容器、依赖、随机种子和数据快照可追踪;叙事可复现性要求报告中的图表、指标和结论能回到生成它们的代码。Quarto把后一条链拉近,但若上游数据持续变化、镜像只写latest,报告依然可能无法重现。
最小实践:让报告附带机器可读清单
下面脚本不依赖AWS,作用是阻止“报告有了,但输入、镜像或评测集说不清”。保存为verify_manifest.py,运行python verify_manifest.py:
from pathlib import Path
import hashlib
import json

required = ["data_snapshot", "image_digest", "train_seed", "test_scope", "metric"]
manifest = {
    "data_snapshot": "s3://demo/loans/2026-09-21/",
    "image_digest": "sha256:9c2b...",
    "train_seed": 42,
    "test_scope": "customer-disjoint holdout",
    "metric": {"name": "AUC", "value": 0.834},
}

missing = [key for key in required if not manifest.get(key)]
if missing:
    raise SystemExit(f"missing fields: {missing}")

evidence = Path("model_evidence.json")
payload = json.dumps(manifest, ensure_ascii=False, sort_keys=True, indent=2)
evidence.write_text(payload, encoding="utf-8")
digest = hashlib.sha256(payload.encode()).hexdigest()
print(f"manifest ok: {digest[:12]}")
五个字段分别锁定数据快照、容器镜像、随机种子、测试范围和核心指标;哈希可写进报告或部署记录,后续修改就会留下差异。示例已在本次任务中用Python 3实际运行并生成校验摘要。它没有复现AWS演示,也没有证明0.834这个AUC适合任何真实贷款决策。
开发者与团队会得到什么
对个人开发者,收益是R验证、Python建模和报告不必通过手工文件接力。对平台团队,收益是把许可、镜像、身份、网络、日志和模型访问纳入同一治理面。Posit Assistant可把Amazon Bedrock作为模型提供方,并在客户自己的账户与区域中运行,但这不等于提示、输出和训练数据天然满足所有合规要求。
成本也没有消失。官方前置条件包括Posit许可、定制镜像管理、ml.t3.xlarge或更大实例,以及可选的Bedrock模型权限。团队仍负责镜像补丁、最小权限、端点监控和闲置资源回收。一个更舒服的工作台,可能把云资源忘记关闭这件事也变得更容易。
具体场景:同一指标为何会有两个答案
假设风控分析师先在R里删掉缺失收入记录,随后Python训练脚本却把缺失值填成中位数。两边都能生成AUC,报告只抄较高数字时,团队很难发现样本口径已经不同。统一工作区不能自动阻止这种分叉,却能让R脚本、Python特征代码和Quarto引用处在同一版本库,由检查流程比较数据行数、字段摘要与特征定义。
建议把每个关键检查输出成机器可读文件,而不只留在Notebook单元格:R写出分布与缺失率,Python读取同一份检查结果后才允许训练;部署前再比对特征列表和数据快照。这样,语言之间不是靠人记住约定,而是靠产物建立契约。
AI助手也要遵守同一规则。它可以生成Athena查询,但查询应先只读、限定扫描范围并记录最终SQL;可以建议特征,却不能绕过数据用途和标签泄漏审查。把助手放进受治理空间,减少的是密钥散落,不会自动消除错误分析。
我的判断与实践建议
统一工作区最重要的产物不是模型文件,而是可追踪的决策链。 如果R检查发现一个分布问题,Python训练应该能引用它;如果报告展示一个指标,读者应该能找到对应数据快照和测试范围。
适合这套方案的,是已有AWS治理体系、同时使用R与Python、需要浏览器工作台和受控身份的团队。不适合只为短期探索购买复杂平台,也不适合把单次合成数据演示当成金融生产模板。
落地时先做四项:镜像固定到摘要而非latest;训练与部署角色分离;每个报告附机器可读清单;端点创建时同步建立预算、监控和自动下线条件。AI助手可以写SQL和代码,但数据泄漏、公平性和业务适用性仍需独立检查。
你的数据项目最常在哪次工具切换中丢掉上下文:取数、建模、部署,还是写报告?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。