
当智能体在低峰期很快、并发一高却有人等很久,团队通常先加GPU或换快模型。一篇9月10日提交的论文给出另一种解释:问题可能发生在请求进入推理服务之前。它的核心判断是“步骤已就绪”不等于“应该立刻释放”;控制排队中的在途工作,可能比盲目并发更能改善最慢用户的体验。
论文研究了什么
论文原文研究由多轮模型调用和工具交互组成的智能体工作流。多数运行时采用贪心策略:某一步只要依赖满足,就立刻提交给共享推理服务。资源充足时这很自然;竞争激烈时,已提交但未完成的请求会越积越多,而且交给下层服务后,上层调度器往往失去重新排序能力。
作者提出把“就绪”和“释放”解耦,同时决定下一步放哪个请求、维持多少未完成工作。实验使用来自软件工程任务的真实智能体执行轨迹,在多个模型和到达率下比较;论文报告轻载时与贪心策略相近,竞争时工作流P95完成时间最高获得3.50倍改善。
必须加粗边界:3.50倍是论文特定负载下的最好结果,不是所有系统的平均加速,也没有证据证明单个模型推理本身快了3.50倍。
为什么平均延迟会骗人
用户感受到的是整条工作流结束时间,而不是某一次模型调用。一个包含“规划—查库—改代码—跑测试—复核”的任务,只要某个关键步骤在队尾卡住,前面节省的几秒都没有意义。
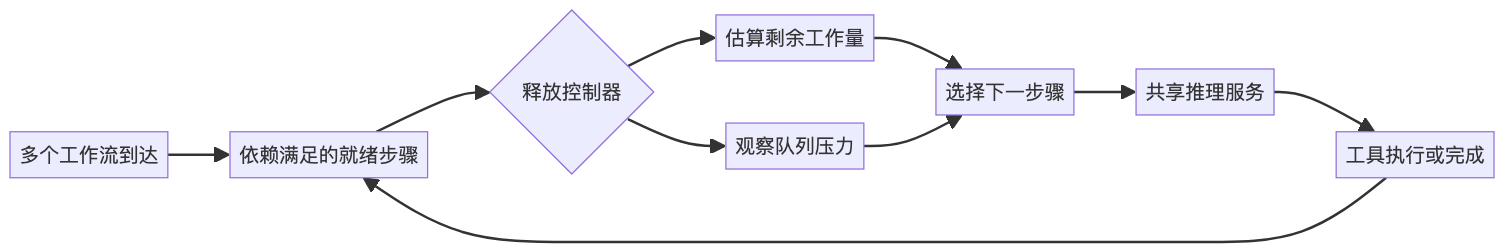
论文引入均值与条件风险价值(Conditional Value at Risk,CVaR)的组合目标。通俗说,平均值关心“整体通常多快”,CVaR更关注分布尾部那批特别慢的任务。调度器既不完全牺牲大多数请求,也主动压低最糟一段体验。
一个服务端例子
假设工作流A只剩一次短复核就能结束,工作流B刚拆出十个长子任务。贪心释放会让B迅速占满队列,A的短复核反而排在后面。尾风险调度会估计两者剩余工作,优先让A闭环,同时限制B的在途数量。GPU没有变快,但用户看到A更早完成,队列也保留了重新排序空间。
这种策略并非“短任务永远插队”。如果一直偏爱短任务,长任务会饥饿;真正实现要加入等待时间、优先级、租户公平性与最大并发约束。
我的判断:下一轮优化在模型外
智能体基础设施正在重演分布式系统的老问题:吞吐、平均值与尾延迟互相牵制。模型团队容易盯每秒Token数,应用团队更该量端到端完成时间。只优化单次推理,很可能把瓶颈推到工具等待、队列或依赖图。
这篇论文的价值不是给出可直接复制的万能算法,而是提醒我们保留“未提交的选择权”。一旦把所有就绪请求都灌进下层队列,上层掌握再多业务优先级也难以补救。
可执行检查表
- 同时记录单次调用、整条工作流的P50、P95和P99,不只看均值。
- 区分“就绪队列”和“已释放未完成队列”,为后者设置动态上限。
- 估算每一步的Token、工具时长和关键路径位置,允许估算值持续校正。
- 压测轻载、稳定高载与突发三种到达模式,防止只在一类流量上好看。
- 加入租户公平与最长等待保护,再比较成本、吞吐和尾延迟。
适合采用这种思想的是共享推理集群、多步骤代理和并发子智能体;单用户、低负载或下层服务已经提供强优先级调度时,收益可能有限。论文结果仍需独立复现,生产迁移前应回放自己的真实轨迹。
怎样验证它没有“优化报表、伤害用户”
调度实验至少要并排看四组数字:工作流完成率、P95完成时间、单位任务成本和最长等待时间。只看P95可能隐藏少量长任务被饿死;只看吞吐又可能让交互用户排在批处理后面。还要按任务类型分层,因为五分钟代码修复与两小时资料研究放在同一分布里,平均值没有解释力。
一个低风险试验是先离线回放。把过去一周每一步的就绪时间、估算Token和真实完成时间写成事件流,让贪心策略与候选策略在同一轨迹上模拟。若候选方案改善尾部却显著增加成本或超时数,就调低在途预算或加入年龄提升。在线阶段先给少量租户启用,并保留随时退回先进先出队列的开关。
还需警惕估算误差:模型输出长度和工具耗时都可能突变。调度器应该把预测当信号而非真值,持续用实际结果校正,并在不确定性高时采取保守限流。
你的智能体系统现在优化的是平均响应,还是那批最容易拖垮体验的慢任务?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。