
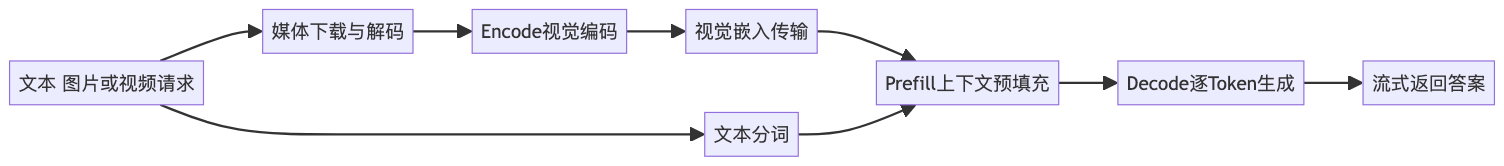
一张图片并不是“直接塞进大模型”。它先被解码成像素,再由视觉编码器变成向量,语言模型才读取上下文并逐词回答。把编码、预填充、解码分开排队,就叫EPD拆分。你读完会知道:多模态为什么首字慢,以及什么时候拆分反而不划算。
最新事件:图片请求为什么会拖慢纯文字
NVIDIA在2026年9月9日公开Dynamo的多模态服务测试,重点讨论Encode-Prefill-Decode(编码—预填充—解码,简称EPD)拆分。官方在特定Qwen3.5 122B A10B、NVIDIA 4位浮点格式(NVFP4)、四张GB200及额外编码图形处理器(GPU)的测试中,报告图片密集负载最高可获得5倍更快的首个词元(Token)时间和7倍端到端加速;但也明确指出,长输出或轻媒体请求可能收益很小甚至倒退。
这次更新适合用来讲一个长期有用的概念:多模态模型的一次回答,实际上是三种计算特征很不同的工作。
这个概念解决什么问题
如果视觉编码、上下文预填充和逐词解码都挤在同一组GPU、同一个队列里,十张图片的请求会先占住资源。后面的纯文字请求明明不需要看图,也可能等它完成视觉处理,这叫队头阻塞。EPD拆分让视觉任务走自己的队列,再把得到的视觉向量交给语言模型,三段可以独立扩容和调度。
生活类比:餐厅的三道工位
把请求想成餐厅订单:洗切食材是Encode,厨师一次读完订单并备好锅是Prefill,之后一道道出菜是Decode。如果洗切和炒菜共用一张案台,大份食材会挡住只点饮料的客人;设独立备菜区能减少排队。
类比的边界是:GPU阶段不是完全独立的人。Encode产生的视觉向量必须传给Prefill,拆开会新增网络传输、调度和缓存成本;而Decode还会反复读取键值缓存,资源行为比“逐道出菜”复杂得多。
去掉类比后的准确定义
Encode指媒体预处理后,视觉Transformer(Vision Transformer,ViT)把图像或视频转换为视觉嵌入;Prefill指语言模型并行处理全部输入Token和视觉嵌入,建立键值缓存并准备第一个输出;Decode指模型利用缓存,按步生成后续Token。EPD disaggregation就是把这三类角色从一个聚合工作进程中拆为可独立调度、批处理和扩缩容的服务阶段。
最小实践:先用估算器判断值不值得拆
这个练习不连接模型,只用三段耗时和拆分开销建立第一版判断。无需安装依赖,保存为epd_estimator.py后运行python3 epd_estimator.py:
from dataclasses import dataclass

@dataclass
class Workload:
    encode_ms: float
    prefill_ms: float
    decode_ms: float
    transfer_ms: float
    queue_saved_ms: float

def compare(w: Workload) -> None:
    aggregated = w.encode_ms + w.prefill_ms + w.decode_ms
    epd = (w.encode_ms + w.transfer_ms + w.prefill_ms
           + w.decode_ms - w.queue_saved_ms)
    gain = (aggregated - epd) / aggregated * 100
    print(f"聚合架构: {aggregated:.1f} ms")
    print(f"EPD估算: {epd:.1f} ms")
    print(f"端到端变化: {gain:+.1f}%")
    print("建议:", "进入实测" if gain > 10 else "先保持聚合")

image_heavy = Workload(
    encode_ms=420, prefill_ms=90, decode_ms=260,
    transfer_ms=35, queue_saved_ms=180,
)
compare(image_heavy)
encode_ms、prefill_ms和decode_ms是当前聚合服务的分段观测;transfer_ms是拆开后的视觉向量传输和协调成本;queue_saved_ms估计独立排队节省的等待。函数同时算两条路径,并用10%作为“值得进入真实压测”的粗筛线,不是上线结论。
本次任务已在Python 3环境实际运行,示例输出为聚合架构770.0毫秒、EPD估算625.0毫秒、端到端变化+18.8%,建议进入实测。它验证的是计算逻辑,不是任何GPU或模型性能。
至少三个常见误区
- 拆分一定更快。 图片少、输出很长时,Decode占主导,传输开销可能吃掉收益。官方测试中固定五张图、输出从128增长到2048 Token后,共置EPD从11.8%收益变为2.5%倒退。
- 首字快等于总回答快。 EPD主要改善视觉编码与排队,长回答的逐词生成并不会自动加速。
- 多加编码GPU就行。 若43%的首字时间发生在ViT启动前,媒体下载和解码才是瓶颈,应该先做并行媒体解码。
- 纯文字流量与此无关。 混合队列中,文字会被图片挡住;官方50:50流量测试里,文字平均首字时间从92.3降到53.3毫秒,但这是特定环境的厂商结果。
适用与不适用场景
适合:多图或视频输入、回答较短、文字与图片混合且首字敏感、小型或量化语言模型、已有异构GPU资源。此时视觉编码占比较高,独立批处理容易回本。
不适合:单张小图、超长输出、低并发、网络传输慢、运维团队还没有分段观测。简单聚合架构更容易调试,也可能拥有更低的单请求额外开销。
我的判断
EPD不是“多模态服务标配”,而是一种排队与资源隔离工具。我的判断依据是NVIDIA原始测试同时给出正反结果:十张图、1024输出Token时首字明显改善,但输出越长,端到端优势越窄。决定是否拆分的第一张图表,应是自家流量里Encode、Prefill、Decode和排队时间的占比,而不是厂商最高倍数。
5分钟实践题
把代码中的decode_ms从260改为1200,其他数字不变,再运行一次。然后把transfer_ms从35改为220。记录两次收益,并用一句话回答:你的系统更怕长输出,还是更怕跨节点传输?如果仍想拆分,下一步应采集第50与第95百分位(P50、P95)首字时间和每Token间延迟,而不是继续调估算值。
你的多模态应用更像短答案识图,还是长答案视频分析?这会怎样改变你对EPD拆分的判断?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。