新模型的最大风险往往不是接不通,而是它返回了看似正常的结果,却在你的真实业务上静默变差。Claude Sonnet 5.5 值得试,但正确姿势是先跑金样本、再小流量灰度、最后按门禁扩容。
Anthropic 9 月 28 日发布 Claude Sonnet 5.5。官方报告它比 Sonnet 5 输出快 30% 以上,输入价格为每百万 token 2 美元,输出 10 美元,缓存读取 0.20 美元,与 Sonnet 5 单价相同。发布方称大多数任务因 token 减少可降低最多 30% 单任务成本,Terminal-Bench 4.0 得分为 70.6%。这些都是官方或合作方口径,不能替代你的客服、代码审查或文档抽取数据。
更值得注意的是迁移边界。官方给出的 Claude Platform 模型 ID 是 claude-sonnet-5-5;如果以前关闭 thinking,需换到新的 between_tools 设置。平台、云厂商和工具用法可能有差异,应以安装当天的迁移文档为准。
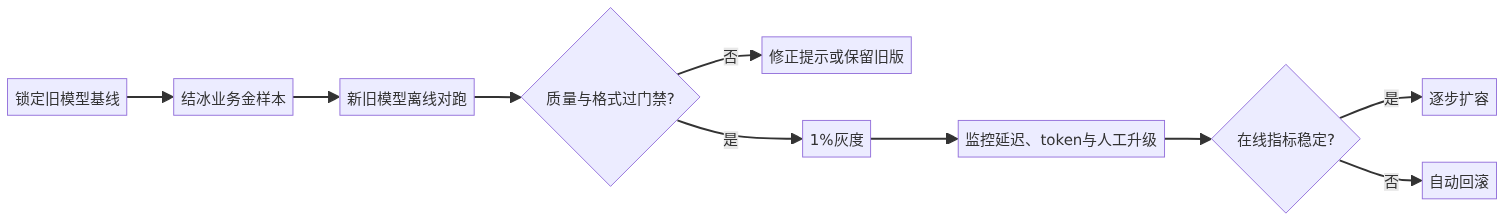
最小实践:先做一个离线迁移门禁
from statistics import median

old = [
    {"ok": 1, "latency": 1200, "tokens": 900},
    {"ok": 1, "latency": 1400, "tokens": 950},
    {"ok": 1, "latency": 1600, "tokens": 1100},
    {"ok": 0, "latency": 1900, "tokens": 1250},
]
new = [
    {"ok": 1, "latency": 900, "tokens": 700},
    {"ok": 1, "latency": 1000, "tokens": 760},
    {"ok": 1, "latency": 1100, "tokens": 820},
    {"ok": 1, "latency": 1300, "tokens": 900},
]

def metrics(rows):
    return {
        "success": sum(r["ok"] for r in rows) / len(rows),
        "p50_ms": median(r["latency"] for r in rows),
        "avg_tokens": sum(r["tokens"] for r in rows) / len(rows),
    }

a, b = metrics(old), metrics(new)
checks = {
    "quality_not_worse": b["success"] >= a["success"],
    "latency_not_worse": b["p50_ms"] <= a["p50_ms"] * 1.10,
    "tokens_not_worse": b["avg_tokens"] <= a["avg_tokens"] * 1.10,
}
print(a, b, checks)
assert all(checks.values())
依赖只有 Python 标准库,保存为 migration_gate.py,运行 python migration_gate.py。本次在 Python 3.9.6 实际运行,成功率从 0.75 到 1.0,P50 延迟从 1500ms 到 1050ms,平均 token 从 1050 到 795,三项断言通过。这是门禁逻辑演示,数据为合成值;本次未用 API 密钥调用 Sonnet 5.5,不得把输出当成模型实测。
代码里的 ok 不应由模型自己说了算。可执行任务用测试结果,结构化抽取用 schema 校验和字段准确率,客服用明确的解决率与升级率。延迟至少看 P50 和 P95,成本要按整个任务的输入、输出、缓存、工具调用和重试合计,不能只比每百万 token 单价。
三个容易忽略的回归
第一,结构仍然合法,含义却变了。例如“需人工复核”的阈值变松,JSON 校验不会报错。第二,平均更快,尾部更慢。工具链任务一旦多两次重试,P95 可能比均值更早暴露问题。第三,发布方的安全回退可能改变高风险任务行为。官方说 Sonnet 5.5 的高风险网络安全请求可回退到 Sonnet 5,与权限、审计和用户预期有关的任务要专门测。
我的判断是,Sonnet 5.5 最有吸引力的不是某个榜单分数,而是“更少步数完成日常任务”的潜力。但这也要用你的转人率、工具失败率和每任务总成本证明。合适场景是边界清楚、可自动判分的高频工作;开放式架构决策、法律与医疗结论仍应保留人工责任链。
今天就可以做的事,是从过去一周挑 30 个真实任务,隐去敏感数据,同时跑新旧模型,把“正确、可接受、需升级”的标准写成机器可读规则。
金样本要包含均匀地“很简单”和“很难”,更要包含生产环境里最容易被忽略的灰色任务。例如客服回复语气正确但政策过期,代码修复通过单元测试却越出用户要求,文档抽取字段完整但将“不超过”读成“至少”。这些样本很难靠通用榜单反映,却是企业真正要承担损失的地方。
评估时也要固定提示词、工具版本、检索语料快照和随机性配置。否则质量差异可能来自索引更新或工具超时,却被误认为模型能力变化。对自由文本任务,不要只用新模型给旧模型打分;可以混合规则、双盲人审和多模型裁判,且把分歧样本留给人检查。
灰度阶段最少要看四类指标。第一类是业务结果,如解决率、合并率或正确抽取率;第二类是风险信号,如人工升级、用户撤回和安全拒绝;第三类是体验,如首包、P95和卡住率;第四类是总成本,包含 token、缓存、搜索、工具执行、重试与人工复核。只要其中一项超过预先定义的线,流量就应自动回到旧模型。
回滚机制必须先于扩容运行一次。新旧模型的请求与响应日志要能区分,对话状态要知道能否中途切回,结构化输出的下游消费者要能容忍两个版本的正当差异。如果团队没有在演练环境中证明五分钟内能回滚,就不应把“随时可回滚”写进发布计划。
对有会话状态的应用,迁移还需要定义“会话粘性”。一种稳妥做法是旧会话继续用旧模型,新会话才进入灰度,这样不会在对话中途改变行为。如果必须中途切换,就要测试新模型是否能正确理解旧版本产生的工具结果、思考块和摘要,同时避免重复执行已经成功的外部操作。任何有副作用的工具都应有幂等键,否则回滚模型本身也可能造成二次损害。
此外,不要在发布当天同时改模型、系统提示词、检索策略和工具集。一次只改一个主要变量,转换门禁才能把差异归因到模型。如果业务迫使多项同时上线,至少要保留独立的功能开关和版本标记,让日志能还原一次结果究竟由哪组配置产生。
你的模型迁移现在有自动回滚线,还是仍靠用户投诉发现问题?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。