
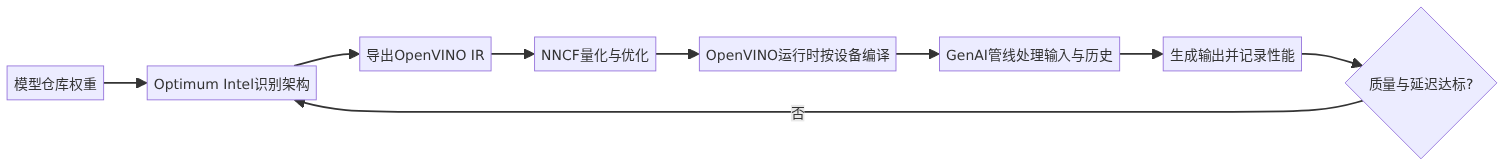
模型仓库里的权重只是“原材料”,不是点击即用的应用。要在自己的CPU、GPU或NPU上运行,还要经历导出、优化、量化、运行时加载和输入输出适配。看懂这条流水线,你遇到“不支持架构、内存不够、接口变了”时,就能定位是哪一层出问题,而不是反复重装。
最新事件:一组版本为什么要一起发布
OpenVINO 2026.4于9月16日发布,OpenVINO GenAI 2026.4和Optimum Intel 2.2于9月17日跟进。新版本增加Gemma 4、Qwen3-ASR、DeepSeek-OCR-2等模型支持,OpenVINO GenAI还为Qwen3-VL-Embedding加入EmbeddingPipeline,并弃用旧的start_chat()与finish_chat()调用方式,改为把ChatHistory直接传给generate()。
可靠来源:OpenVINO 2026.4发布页、OpenVINO GenAI 2026.4发布页、Optimum Intel 2.2发布页。这不是当天新闻,而是过去7天内的开源更新;长期概念是本地推理流水线。
它解决什么问题
同一模型在训练框架里保存的权重,未必能被目标硬件高效执行。模型可能包含新算子、动态形状或多模态预处理,设备也有不同指令集和内存限制。工具链的任务,是把“研究形态的模型”变成“目标运行时理解并能优化的计算图”。
生活类比是把建筑设计图交给不同施工队:Optimum Intel像翻译和出图人员,OpenVINO中间表示(Intermediate Representation,IR)像统一施工图,NNCF像材料减重与规格优化,OpenVINO运行时像真正施工的机器,OpenVINO GenAI则把对话、视觉和语音等常用流程包装成可调用管线。
类比边界在于,模型转换不是无损复印。量化会改变数值精度,新算子可能没有等价实现,预处理差异也会让输出变化,所以“成功导出”不等于“质量与速度都达标”。
准确地说,IR是描述计算图、参数与张量关系的设备无关表示;运行时再针对CPU、GPU或神经处理单元(NPU)编译和调度。量化把权重或激活从较高精度映射到较低位宽,以减少内存与计算,但需要验证准确率、首Token时间和吞吐。
最小实践:在CPU上跑一轮文本生成
建议新建Python 3.11虚拟环境,然后安装官方对应版本:pip install optimum-intel==2.2.0 openvino==2026.4 openvino-genai==2026.4 openvino-tokenizers==2026.4 nncf==3.4。先用官方支持的模型执行导出:optimum-cli export openvino -m ibm-granite/granite-4.0-h-micro --weight-format int8 granite-4.0-h-micro-int8。
导出完成后运行:
from pathlib import Path
import openvino_genai as ovg

model_dir = Path("granite-4.0-h-micro-int8")
if not model_dir.exists():
    raise SystemExit("请先运行optimum-cli导出模型")

pipe = ovg.LLMPipeline(str(model_dir), "CPU")
history = ovg.ChatHistory([
    {"role": "system", "content": "用一句中文回答。"},
    {"role": "user", "content": "什么是模型量化?"},
])
config = ovg.GenerationConfig(
    max_new_tokens=80,
    do_sample=False,
)

result = pipe.generate(history, generation_config=config)
print(result)
代码先检查导出目录,再创建CPU管线;ChatHistory显式传入消息;关闭随机采样便于重复比较。示例未在本次任务中实际运行,因为下载模型和安装原生运行时会产生较大网络与磁盘开销,本次环境也不代表读者硬件。不能把这段代码视为已验证的性能结论。
四个常见误区
第一,导出成功就等于模型可用。至少要用代表性提示比较原模型与IR输出。第二,位宽越低一定越快;若设备内核不匹配,转换开销可能抵消收益。第三,把内存不足全归因于权重;KV Cache、视觉编码器、音频缓存和并发请求也占空间。第四,直接混装最新版依赖;Optimum Intel 2.2明确推荐OpenVINO、OpenVINO GenAI 2026.4与NNCF 3.4,生产环境应锁版本。
版本锁定之后还要保存设备信息。相同的IR在不同CPU指令集、集成GPU驱动和NPU插件上,可能选择不同执行路径。至少记录操作系统、处理器型号、驱动、运行时版本、输入长度和生成长度;比较升级前后时固定提示与随机策略。否则“新版本快了20%”可能只是输入更短或缓存已经预热。
质量验证不必一开始就做大型基准。先准备10至30个与你应用直接相关的固定样例,覆盖中文、长输入、边界格式和拒答场景;保存原框架输出,再与INT8 IR逐项比较。若差异集中在某一类输入,再决定回退量化或更换模型,而不是只凭一个聊天示例判断成功。
还有一个容易忽略的坑:API弃用不是立刻不可用,但会提前告诉你迁移方向。继续围绕start_chat()写新代码,会把技术债带进下一次大版本。
适用与不适用场景
这套工具链适合Intel CPU、GPU或NPU上的本地推理,尤其是数据不出设备、低并发服务和AI PC应用。不适合据此断言它在所有硬件上都优于CUDA或其他运行时;跨平台产品还要比较模型覆盖、算子支持、驱动、维护成本和真实负载。
我的判断
本地AI真正的门槛,不是“能下载权重”,而是能把模型、表示、优化和硬件版本固定成可复现的交付物。 新版本扩大模型名单很重要,但对团队更耐用的能力,是保存导出命令、依赖锁、质量基线和设备性能记录。
5分钟实践题
不用下载模型,先为你的目标设备写一张四列清单:模型名与版本、导出工具版本、量化位宽、需要验证的质量与性能指标。再回答:如果输出质量下降,你会先回退量化、导出器,还是运行时?理由是什么?
你第一次本地部署模型时,最容易卡在导出、依赖、显存内存,还是输入输出格式?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。