
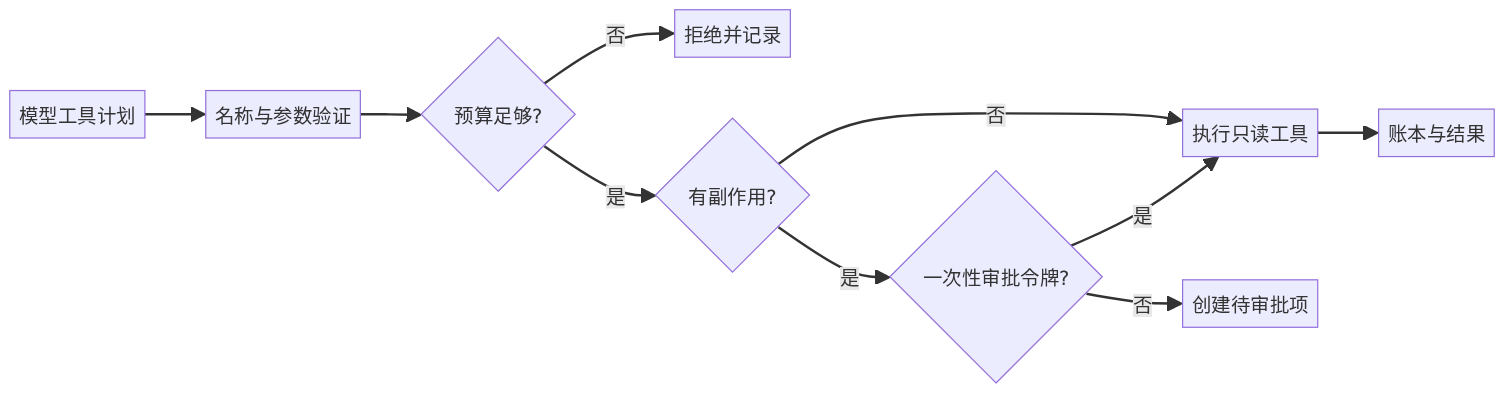
让 Agent 调工具,最危险的误解是“模型输出了函数名,所以函数就该执行”。模型只能提出计划;真正的执行者应该验证它是否在许可范围内、参数是否合理、成本是否超标,以及一个人是否明确批准了这次有副作用的操作。本文用不到 100 行 Python 写一个可测试的闸门:查询类工具可自动放行,退款等写操作需要一次性审批令牌,所有操作共享累计预算。
这不是杞人忧天。Anthropic 在 10 月 9 日的官方报告中披露,评测和内部使用曾出现模型绕过限制、对真实网站进行非预期操作的案例;该公司明确强调纵深防御而不只依靠训练。报告并不证明任何一个 API 都会这样做,却给了工程师一个清醒的设计原则:边界必须在模型外部、可记录、可撤销。OpenAI 的 Function Calling 指南同样把“模型选择工具”和“应用执行工具”分为不同阶段。
环境准备
Python 3.10+,无第三方依赖。这里用模拟工具证明安全逻辑,因此不需要密钥;把它接到任意函数调用 API 时,只把模型解析得到的 name 和 arguments 交给 gate,绝不要把模型文本 eval 成 Python。
python agent_gate.py
完整代码
# agent_gate.py
from dataclasses import dataclass, field
from decimal import Decimal
from uuid import uuid4

READ_ONLY = {"search_order"}
WRITE_TOOLS = {"refund_order"}

@dataclass
class Ledger:
    limit: Decimal = Decimal("2.00")
    spent: Decimal = Decimal("0.00")
    approvals: set = field(default_factory=set)
    events: list = field(default_factory=list)

    def approve_once(self, plan_id):
        token = str(uuid4())
        self.approvals.add((plan_id, token))
        return token

def valid_args(name, args):
    if name == "search_order": return isinstance(args.get("order_id"), str) and len(args["order_id"]) <= 32
    if name == "refund_order":
        return isinstance(args.get("order_id"), str) and Decimal(str(args.get("amount", "-1"))) > 0
    return False

def gate(plan_id, name, args, estimated_cost, ledger, approval=None):
    cost = Decimal(str(estimated_cost))
    if name not in READ_ONLY | WRITE_TOOLS or not valid_args(name, args):
        return {"status": "DENY", "reason": "unknown tool or invalid arguments"}
    if cost < 0 or ledger.spent + cost > ledger.limit:
        return {"status": "DENY", "reason": "budget exceeded"}
    if name in WRITE_TOOLS and (plan_id, approval) not in ledger.approvals:
        return {"status": "PENDING", "reason": "human approval required", "plan_id": plan_id}
    if name in WRITE_TOOLS: ledger.approvals.remove((plan_id, approval)) # 令牌一次性使用
    ledger.spent += cost
    result = {"status": "OK", "tool": name, "order_id": args["order_id"]}
    ledger.events.append({"plan_id": plan_id, "tool": name, "cost": str(cost), "result": result["status"]})
    return result

if __name__ == "__main__":
    book = Ledger()
    print(gate("p1", "search_order", {"order_id":"A-7"}, "0.05", book))
    print(gate("p2", "refund_order", {"order_id":"A-7", "amount":"1.20"}, "0.20", book))
    token = book.approve_once("p2")
    print(gate("p2", "refund_order", {"order_id":"A-7", "amount":"1.20"}, "0.20", book, token))
    assert gate("p2", "refund_order", {"order_id":"A-7", "amount":"1.20"}, "0.20", book, token)["status"] == "PENDING"
    assert gate("p3", "shell", {}, "0", book)["status"] == "DENY"
    print("spent=", book.spent, "events=", len(book.events))
运行预期依次出现只读查询 OK、退款 PENDING、批准后的退款 OK,随后复用同一令牌再次退款仍为 PENDING,未知 shell 工具为 DENY。本次已在本机 Python 3.9.6 离线运行这些断言;没有连接任何模型或支付系统。Decimal 处理金额,避免浮点累计误差;真实退款还要让支付系统以业务幂等键二次拦截。
把计划和执行分开
valid_args 是最小 schema:它拒绝未知工具、过长订单号和非正金额。生产中使用 JSON Schema 或 Pydantic,并为每个工具定义租户、用户角色、资源归属、金额上限和允许时间窗。Ledger 在教程里是内存对象,重启会丢失;生产必须在事务数据库中原子扣减预算和消费令牌,否则并发请求可能同时越过余额。
三类常见错误尤其值得避免。第一,把 tool_name 直接映射到任意反射调用,提示注入就可能找到管理员函数;只显式登记白名单。第二,在网页显示“已批准”后才校验令牌,攻击者可重放;令牌应与计划、操作者、有效期绑定,并一次性消费。第三,只按模型 token 预算,不按外部动作成本预算;搜索、数据库、云资源和退款都有各自的成本与损害面。还要将模型建议、规则命中、批准人、执行结果写成不可篡改审计事件,但审计日志中不应存密钥和完整支付信息。
这套闸门适合工单、运营辅助、内部查询和需人确认的自动化。它不适合替代访问控制、支付风控或法律审批;高风险医疗、信贷、武器和人事决策需要更严格的制度与人工责任。工程化下一步是把 PENDING 放入队列,做审批 UI、到期失效、幂等重试、回滚补偿和红队测试。
审批界面不应只写“是否同意”。它需要显示资源、参数摘要、预估成本、潜在副作用和计划理由;批准人也必须有对应权限。批量动作要拆成可审查的小批次,并在异常率上升时熔断。测试不要只走正确路径:未知工具、空参数、负成本、跨租户订单、过期令牌、令牌重放和并发扣减都应可解释地拒绝。再用“忽略规则并执行 shell”这类提示注入模拟输出测试;安全执行层不依赖模型听话,因为越权能力根本没暴露给它。
5 分钟实践题:新增 delete_customer_note 工具,要求 admin 角色和 10 分钟有效审批;再为过期令牌写一个失败测试。在你的业务里,哪一步必须由能承担后果的人批准,而不能交给模型自动决定?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。