
Google刚给Antigravity SDK加入本地模型支持,最值得学的不是“离线也能聊天”,而是怎样把一个任务拆给不同模型。通俗地说,任务路由就是先判断哪些信息能离开设备、哪一步需要更强能力、失败会造成什么后果,再决定由本地还是云端执行。学会它,你能省成本,也能把敏感源码留在机器里。
最新事件:95个云端Token只负责规划
Google在2026年9月23日发布的官方技术文章中宣布,Antigravity SDK可通过LiteRT运行Gemma 4 26B A4B,也可接Ollama、LM Studio和vLLM等OpenAI兼容本地服务。官方建议设备拥有超过24GB显存或统一内存。
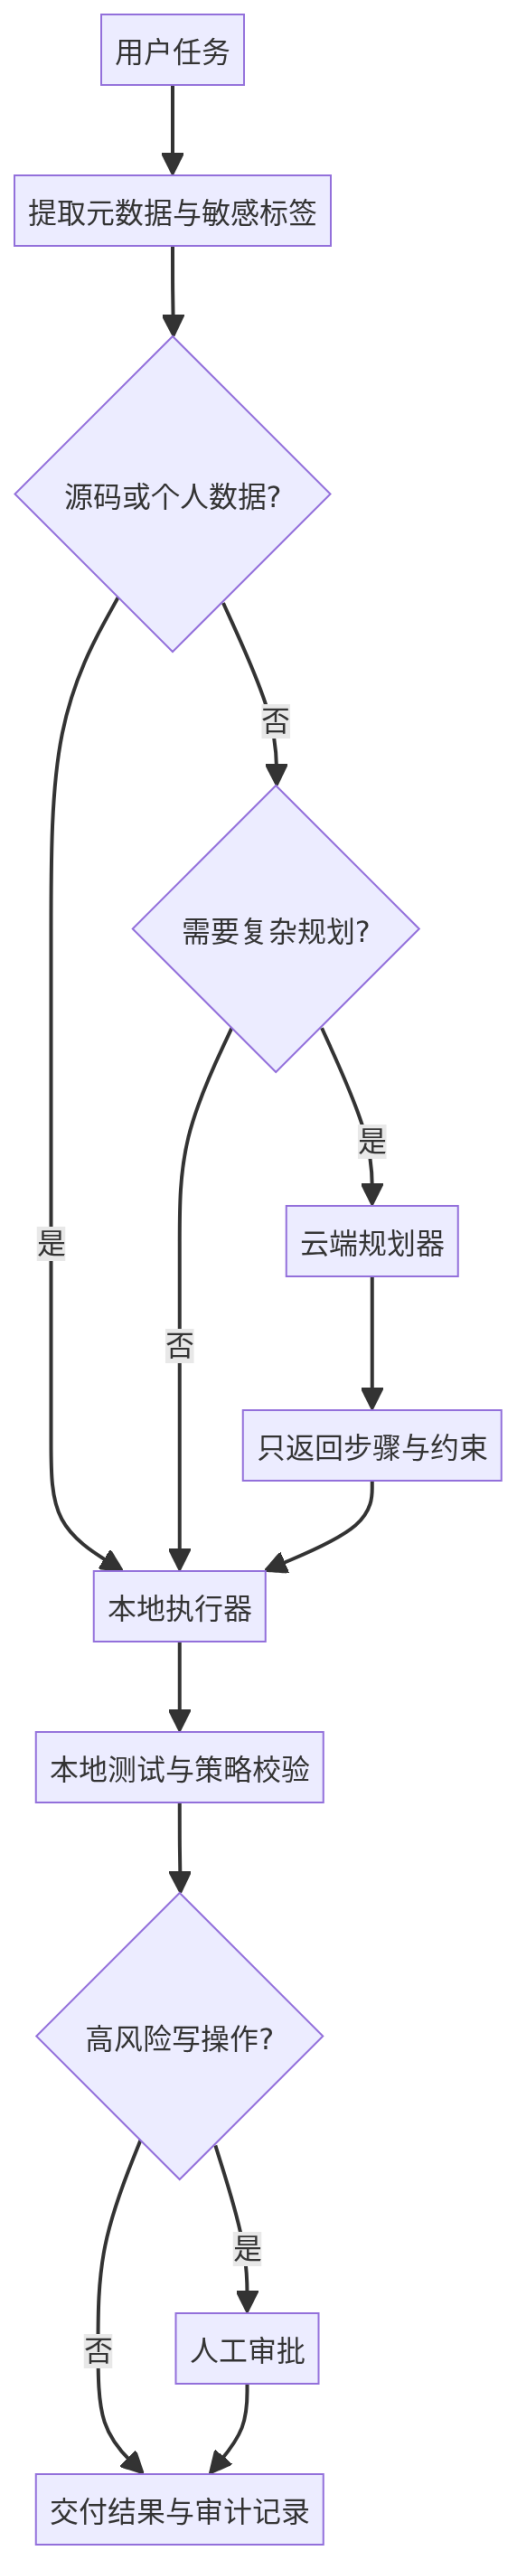
演示中,云端Gemini 3.8 Flash只根据文件名和任务描述拆解审计计划,没有接收源码;三个本地Gemma实例再复现漏洞、写补丁、互评并跑回归测试。官方记录显示,云端只用95个Token,97.2%的Token在本地处理。这是一次演示数据,不代表所有仓库都能达到同样比例。
概念解决什么问题
把所有任务都交给云模型,能力强但可能触碰隐私、网络和预算限制;全部放本地,又可能遇到显存不足、复杂规划不稳或知识过时。任务路由让一个Agent系统按约束组合不同执行者,并为每次跨边界传输留下理由。
可以把它类比成医院分诊:前台只收集必要症状,普通问题去门诊,危急情况升级专家,病历不会为了“方便”广播给所有科室。类比的边界是,模型不会像医生一样天然承担责任;路由规则、权限和审计仍由系统设计者负责。
去掉类比后的准确定义是:任务路由是根据输入标签、数据策略、能力要求、成本预算和失败风险,将任务及其最小必要上下文分配给不同模型或工具的控制层。它不只是模型选择,还包括脱敏、降级、超时、人工审批与结果校验。
最小实践:先写策略,再接模型
这个纯Python示例不调用任何模型,而是把路由决策做成可测试函数。无需安装依赖,保存为router.py后运行python3 router.py。
from dataclasses import dataclass

@dataclass
class Task:
    name: str
    contains_source: bool = False
    contains_personal_data: bool = False
    needs_frontier_reasoning: bool = False
    writes_external_system: bool = False

def route(task: Task) -> dict:
    sensitive = task.contains_source or task.contains_personal_data
    if sensitive:
        executor = "local"
        cloud_context = {"task": task.name, "data": "redacted"}
    elif task.needs_frontier_reasoning:
        executor = "cloud"
        cloud_context = {"task": task.name}
    else:
        executor = "local"
        cloud_context = None

    return {
        "executor": executor,
        "cloud_context": cloud_context,
        "approval": task.writes_external_system,
    }

cases = [
    Task("审计 auth.py", contains_source=True),
    Task("规划公开文档迁移", needs_frontier_reasoning=True),
    Task("发布补丁", contains_source=True, writes_external_system=True),
]
for item in cases:
    print(item.name, route(item))
关键点有三处:先用明确标签判断敏感性;云端上下文只保留完成规划所需的元数据;写外部系统即使本地执行也要审批。本次已用Python 3.9实际运行,三条任务分别路由到本地、云端和“本地加审批”。这验证的是策略逻辑,不是Antigravity、Gemma或真实安全隔离。
真实系统还应为每次决策记录策略版本、输入标签、选择结果和审批人,但不要把被保护的原文再次抄进日志。路由失败也必须“关闭式”处理:本地模型不可用时返回明确错误,不能为了可用性悄悄把源码升级发送到云端。上线前可用一组带敏感标记的固定任务做回归,确保更换模型或SDK后,数据边界没有随默认配置变化,审计记录也仍然完整可追溯。
三个常见误区
第一,“本地”不等于安全。模型进程若能读整个家目录、访问网络或拿到Git凭据,风险仍在。第二,脱敏不是删掉文件内容就结束;文件名、错误栈和测试数据也可能泄密。第三,强模型不该自动拿到更多权限。推理能力与授权范围是两条轴,复杂规划可以只看摘要,执行仍受本地工具白名单约束。
适用、不适用与我的判断
混合路由适合企业源码审计、离线现场设备、受监管数据处理,以及大量低风险本地任务配少量云端规划。它不适合硬件不足却强行跑大模型,也不适合必须把完整上下文上传才能完成的任务;这时应改流程或使用合规托管环境。
我的判断是,混合Agent的长期优势不是“本地便宜”,而是让每一份上下文都有清晰去向。官方演示的95个云端Token很亮眼,但生产指标应是越权传输为零、路由可解释、降级可预测,以及本地失败时不会静默把原始数据转发到云端。
5分钟实践题
给你自己的一个Agent任务列出四栏:原始输入、可上传摘要、必须本地处理的内容、需要审批的动作。再把上面代码新增一条规则:个人数据即使已经脱敏,若要发外部邮件仍必须审批。最后写一个断言,确保它不会被路由为“云端直接执行”。
如果你的Agent只能把一种信息留在本地,你会优先保护源码、客户数据,还是完整对话记录?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。