
多数AI产品所谓“越用越聪明”,实际只是保存聊天或修改提示词,模型权重并没有变化。Shopify公开的GraphQL Agent给出另一条路:把生产失败变成难例,经审查生成成功轨迹,再做监督微调和强化学习。真正可复制的不是96%成本降幅,而是一条能拒绝坏更新的反馈闭环。
发生了什么
PyTorch基金会在9月22日发布由Shopify工程负责人撰写的案例。该Agent为商家编写并执行Admin GraphQL API查询,生产峰值最高约每分钟2000个请求。官方称专用模型质量超过其通用前沿模型基线,年化推理成本估算从约2700万美元降到接近100万美元,降幅96%。
这些数字来自Shopify自己的系统与估算,文章没有公开完整模型、数据集和统一成本表,不能当成普遍承诺。更可核验的细节是:系统提示从约6000个Token压到约1500个学习到的Gist Token;在每分钟350个请求的压测中,首Token时间下降约19%,端到端延迟下降约38%,相同流量所需GPU估算减少约14%。
技术原理:先定义“好”,再挖失败
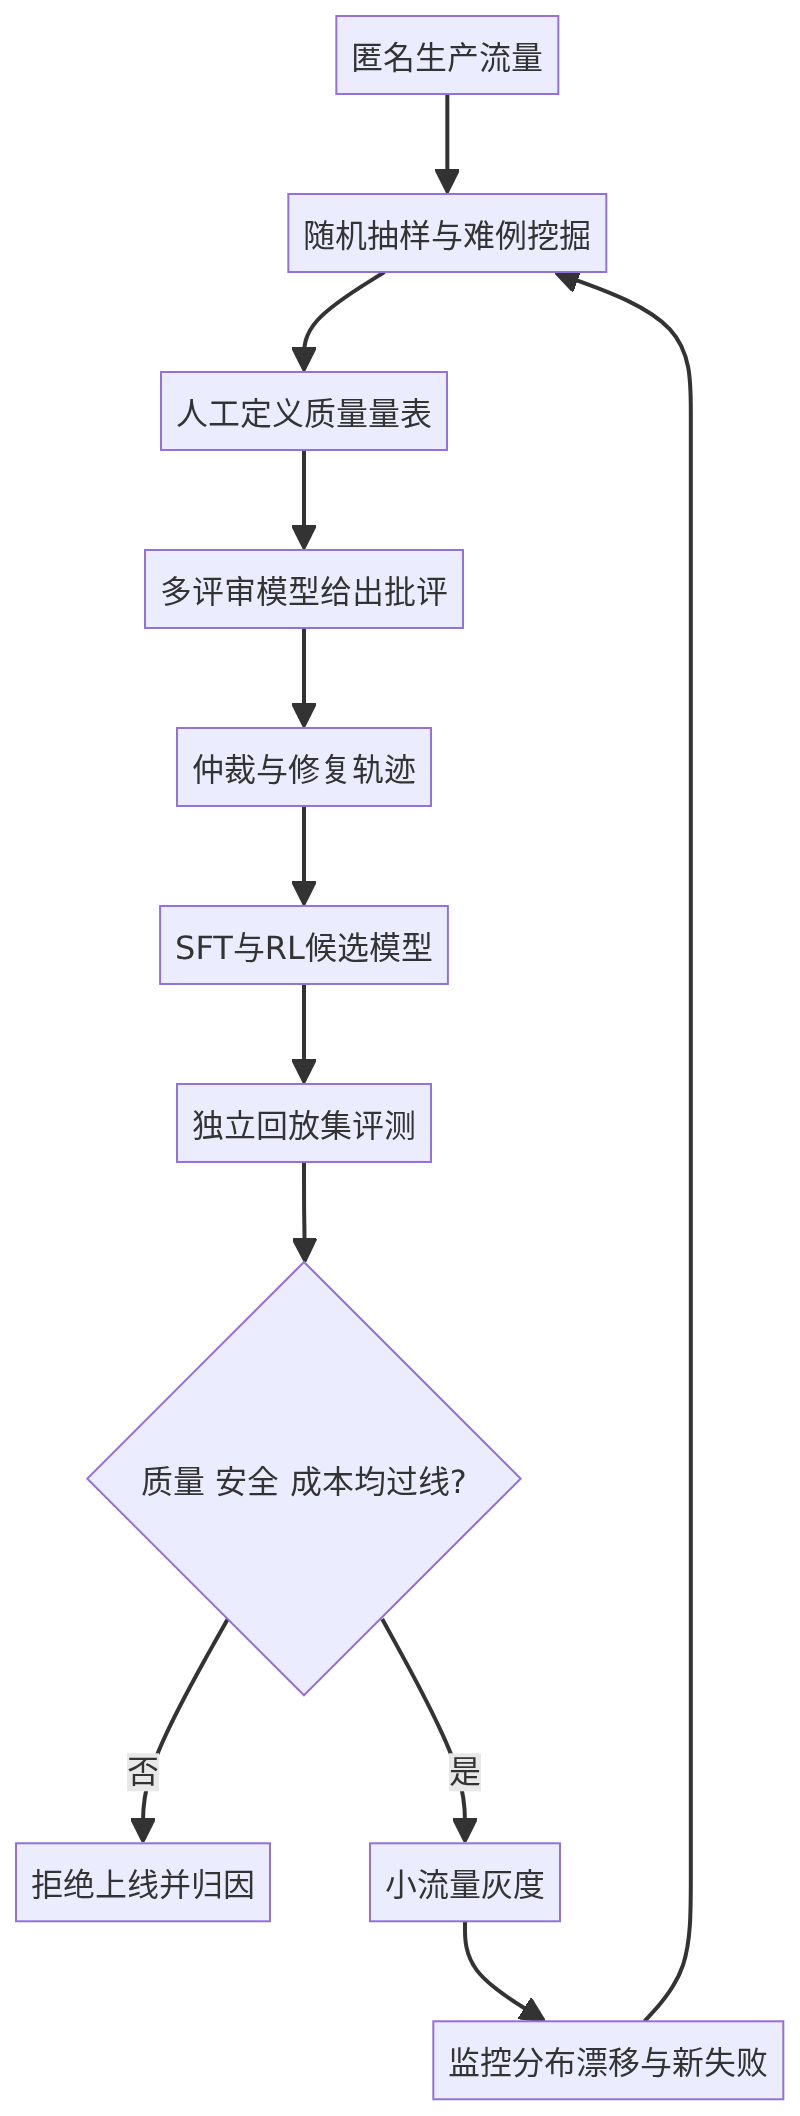
闭环的起点不是训练,而是质量契约。Shopify把完整性、执行成功、回答质量和安全写成有锚点的评分项,同时保留随机流量,避免只看被投诉的极端案例。低分对话成为难例,多个推理模型分别批评,仲裁器合并修复指令,再生成更好的轨迹。
接下来才是参数更新:成功轨迹进入监督微调(Supervised Fine-Tuning,SFT),奖励信号用于强化学习(Reinforcement Learning,RL)。长而稳定的系统提示另走一条压缩路径:教师模型读取完整提示,学生模型用少量可学习的Gist Token逼近输出分布。提示压缩与模型微调解决的是不同成本,不能混为一谈。
最小实践:难例必须过晋级门槛
下面的纯Python脚本从回放结果中选出低分且高频的难例,并要求候选模型在独立集上提升、同时安全分不下降。无需安装依赖,运行python3 gate.py。
from collections import Counter

traffic = [
    {"type": "库存范围", "score": 0.42},
    {"type": "库存范围", "score": 0.55},
    {"type": "退款权限", "score": 0.31},
    {"type": "简单查询", "score": 0.93},
]

hard = [row for row in traffic if row["score"] < 0.60]
priority = Counter(row["type"] for row in hard).most_common()

baseline = {"quality": 0.82, "safety": 0.98, "cost": 1.00}
candidate = {"quality": 0.86, "safety": 0.98, "cost": 0.72}

def promote(old, new):
    return (
        new["quality"] >= old["quality"] + 0.02
        and new["safety"] >= old["safety"]
        and new["cost"] <= old["cost"]
    )

print("hard_cases:", priority)
print("promote:", promote(baseline, candidate))
assert priority[0] == ("库存范围", 2)
assert promote(baseline, candidate)
本次已用Python 3.9实际运行,两条断言通过,优先难例为“库存范围”,候选允许晋级。它只验证数据筛选和门禁逻辑,没有运行PyTorch训练、vLLM服务或Shopify数据,不能虚构为模型复现。
生产门禁还要按任务类型拆分,不能只看一个总分。若退款权限样本很少,它在平均值里几乎没有声音,却可能造成最高风险。应为高风险类别设置最低通过率和零容忍规则,同时保留时间切分测试:训练使用较早流量,验收使用更新且未见过的窗口,避免把重复会话记住后误判为泛化提升。
对开发团队的影响
这套方法改变了Bug处理方式。一次错误不再只变成工单或更长的提示词,而是进入带来源、类型、修复与回归结果的样本生命周期。产品经理负责质量锚点,数据团队负责隐私与抽样,模型团队负责训练,平台团队负责灰度和回滚;任何一环缺失,“自愈”都可能变成自动放大偏差。
具体场景是库存查询:模型把“即将缺货”误解为库存小于零。修复不能只把这一句话塞回训练集,而应补齐不同表达、权限、分页和工具失败,并在从未参与训练的商家与时间窗口上回放。
还要区分用户纠正与可靠标签。用户可能误解规则、恶意诱导,或只偏好一种表达风格。安全做法是把纠正先当“待审核信号”,与工具执行结果、业务规则和抽样人工标注交叉验证,再决定是否进入训练集。否则反馈量越大,模型越可能学会最响亮而非最正确的意见。
边界、风险与我的判断
持续学习适合高频、可评分、工具结果可验证的垂直任务,如查询生成、分类和客服流程。它不适合样本极少、标签高度主观或错误代价极高却没有专家复核的场景。直接用线上对话训练还会遇到个人数据、客户隔离、恶意反馈与版权问题,必须先匿名化、去重、授权并保留删除链路。
我的判断是:持续学习的护城河不是每天训练,而是每天能证明“为什么这批数据值得训练”。平均分上涨可能掩盖某类安全退化;模型评审也可能与被评模型共享盲点。最小落地顺序应是:先建立质量量表和独立回放集,再挖难例,最后才考虑微调。每次上线都要保存数据版本、基础模型、训练配置、分层指标和可回滚工件。
立即可执行的建议是,从最近一周失败工单里只挑一个高频类型,写出五条可判定的通过标准,构建20到50条不参与训练的回放集。若连“好答案”都无法稳定判定,先别启动训练飞轮。
你更信任哪种改进证据:平均分上涨,还是某类真实失败在独立回放集上消失?
关注「蜗牛聊AI」,一起看懂技术变化背后的真正机会。
本文首发于 java4u.cn,转载请注明出处。